
AI 運算進入下一階段後,處理器競爭已不再只是單純比核心數、時脈與峰值算力,而是如何在效能、功耗、成本與實際工作負載之間取得更精準的平衡。Intel 這次公布的新一代處理器架構,也明顯朝這個方向前進:從面向主流 PC 與邊緣裝置的 Intel Core Series 3 (Wildcat Lake),到專攻大規模 AI 推論的 Intel GPU D-series (Crescent Island),以及為企業級 Agentic AI 打造的下一代 Xeon (Diamond Rapids),三條產品線開始形成更清楚的運算分工。
其中,Wildcat Lake 並非一味追求旗艦規格,而是透過 Intel 18A、Cougar Cove、Darkmont、Xe3、NPU 5,以及 UCIe 與 MCP 多晶片封裝,在主流市場重新思考「什麼才是剛剛好的效能」;Crescent Island 則以最高 480GB LPDDR5X 與 Xe3P 架構,瞄準長上下文與大型模型推論;Diamond Rapids 更進一步導入 Fan-out Fabric、Foveros 3D Direct 與最高 256 核心設計。這些涵蓋從 PC 到資料中心的產品,可以看出 Intel 正試圖把不同類型的 AI 工作負載,放到最適合的硬體上執行。
Wildcat Lake:主流市場化的 Panther Lake
Intel Core Series 3,代號 Wildcat Lake,已於 2026/4/16 正式發表,並陸續由 OEM 廠商推出相關系統。Intel 將其定位為由 Core Ultra Series 3,也就是 Panther Lake 架構延伸而來的主流級產品,但並非直接沿用完整配置,而是針對主流價位帶重新取捨功能與硬體規模。
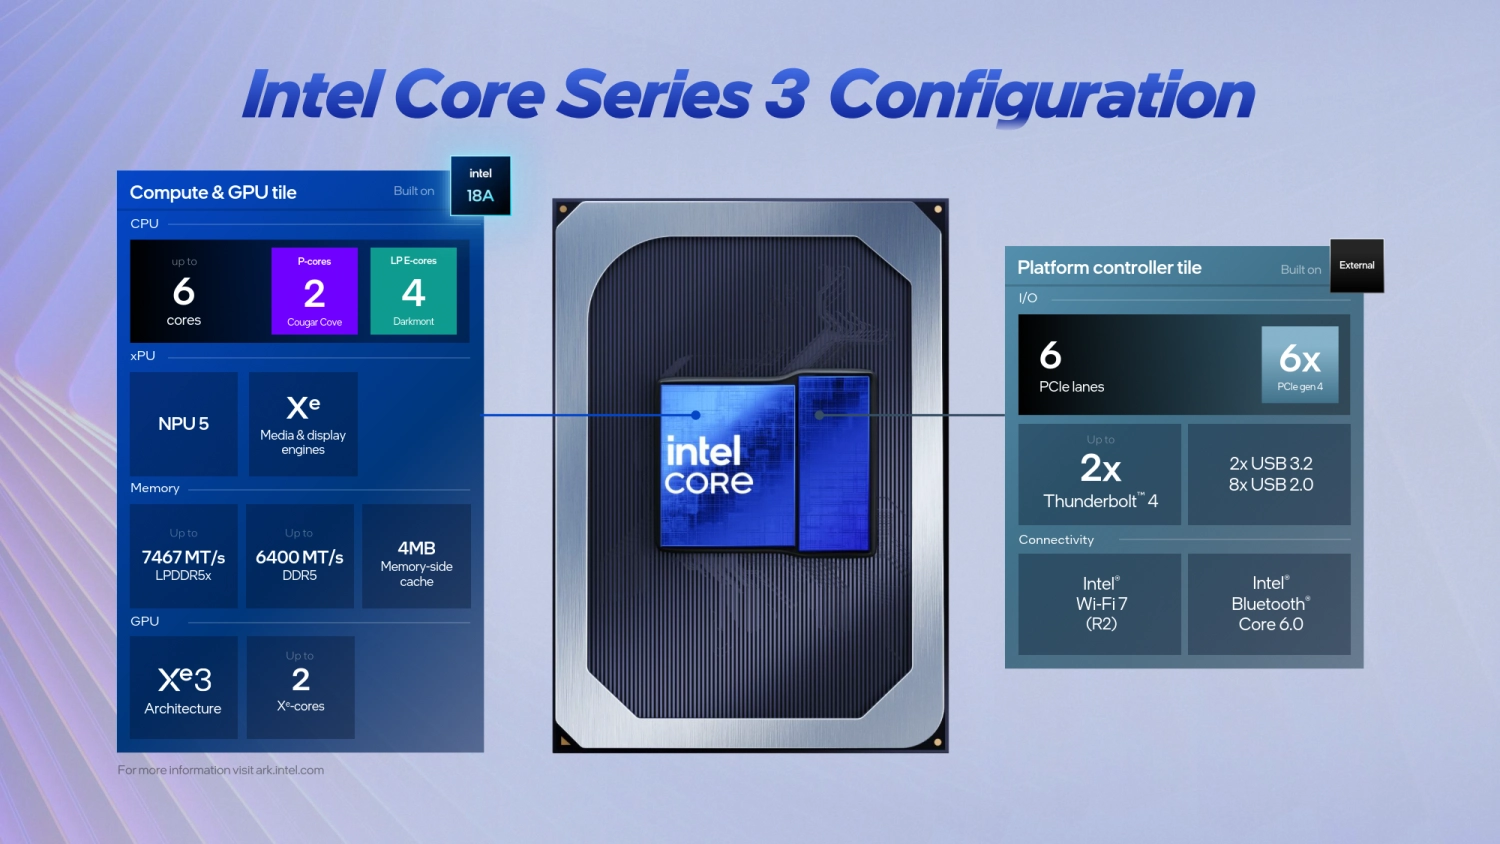
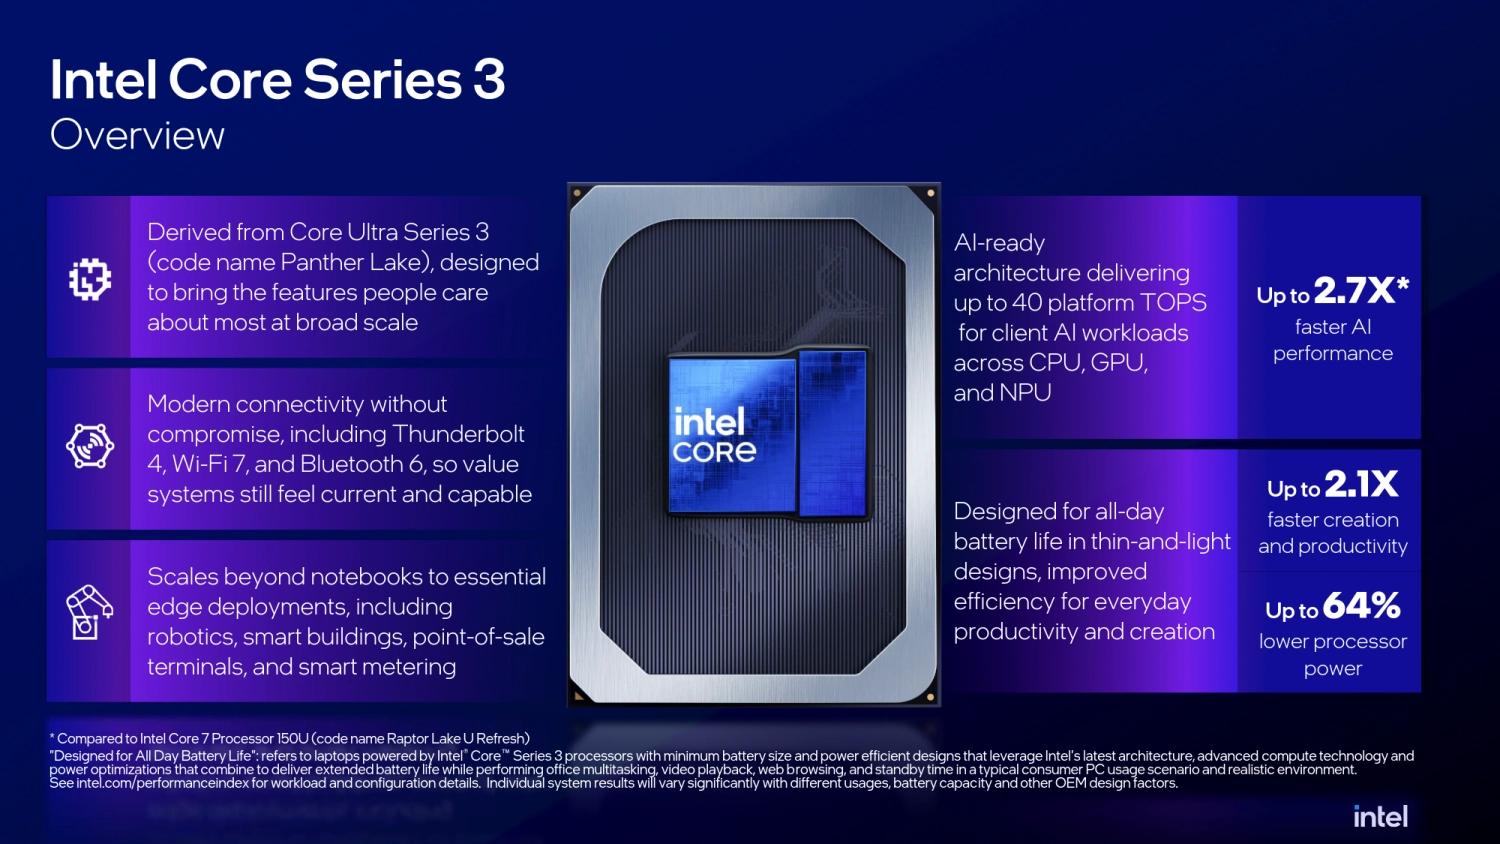
在核心配置方面,Wildcat Lake 最高提供 6 核心,由 2 顆 Cougar Cove P-core 與 4 顆 Darkmont LP E-core 組成,並未配置一般 E-core。處理器採用 Intel 18A 製程打造,同時整合 NPU 5 與 Xe3 GPU,CPU、GPU 與 NPU 合計可提供最高 40 TOPS 的平台 AI 算力。Wildcat Lake 正式產品的 Processor Base Power 為 15W,顯示其整體設計明確鎖定主流輕薄型筆電與高能源效率平台。
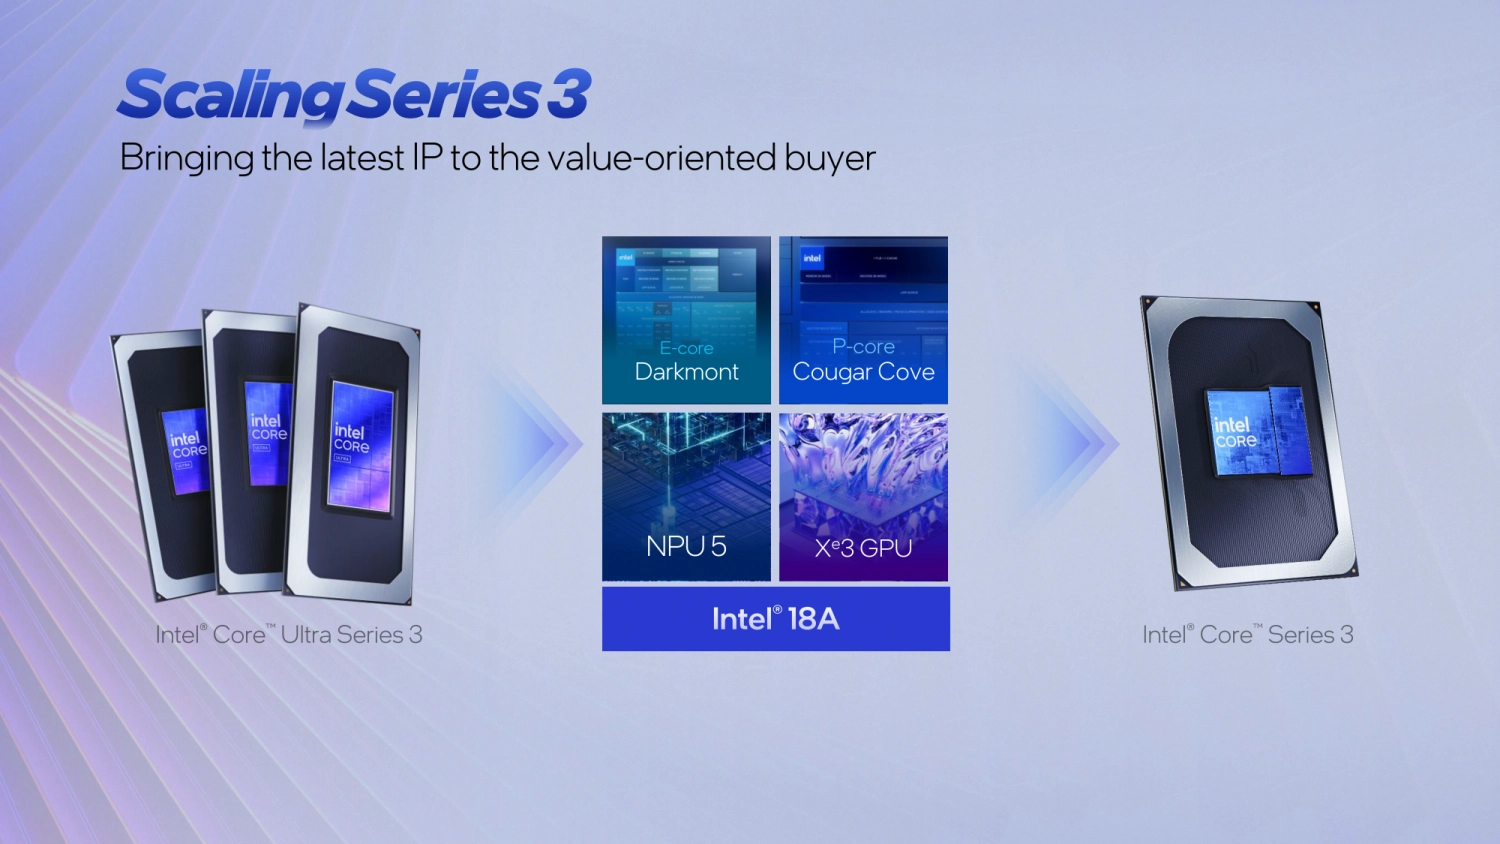
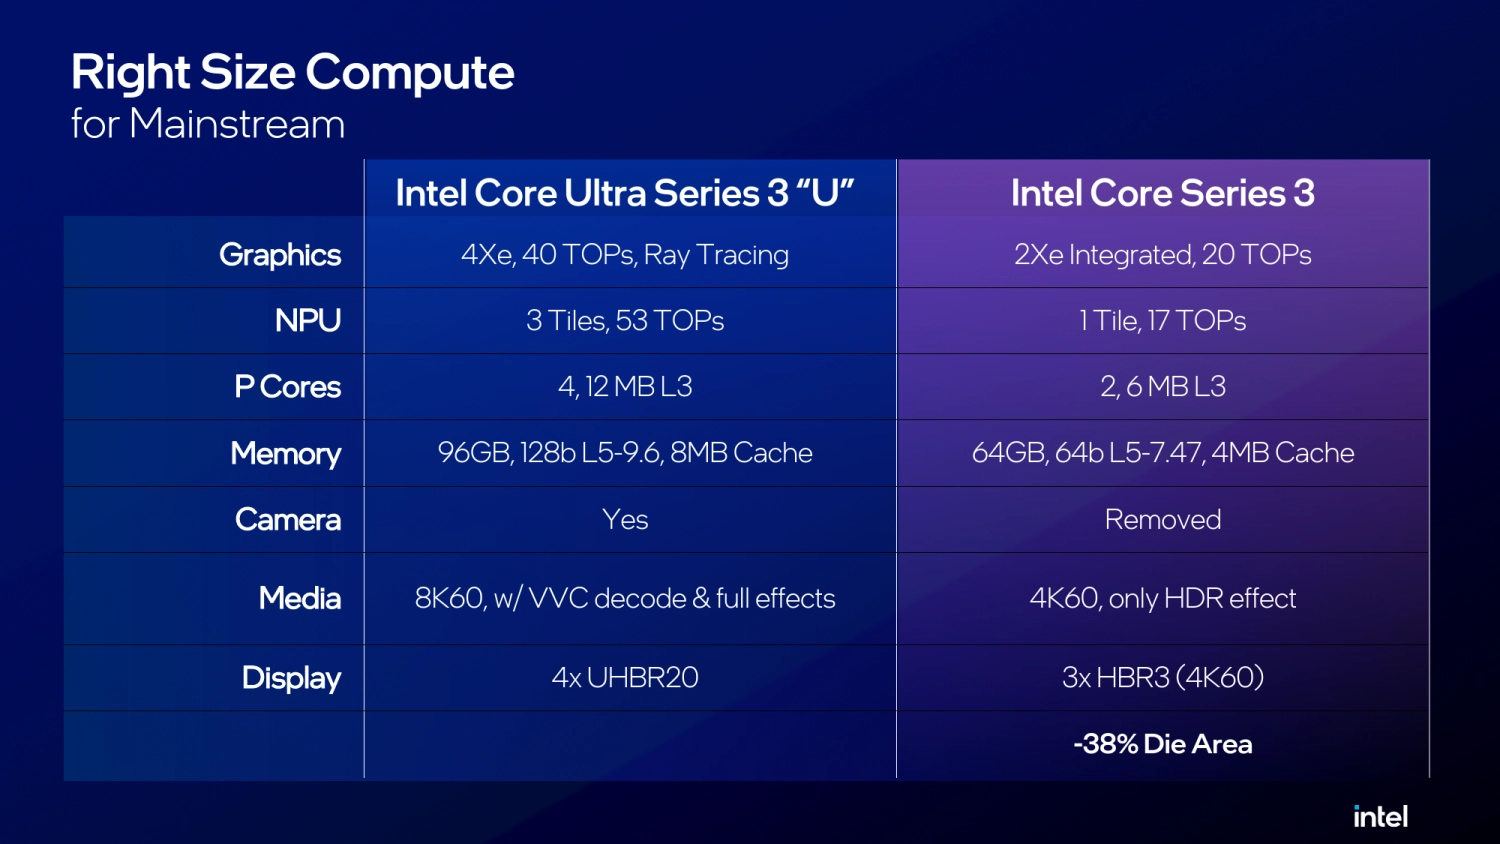
所謂「Right Size Compute」,正是 Wildcat Lake 控制成本與晶片面積的核心策略。相較於 Core Ultra Series 3 U 系列,Intel 並非單純降低時脈,而是直接重新調整各項 IP 的配置規模:GPU 從 4 組 Xe Core、40 TOPS 精簡為 2 組 Xe Core、約 20 TOPS;NPU 由 3 個 Tile、53 TOPS 縮減為單一 Tile、最高 17 TOPS;P-core 也從 4 顆減為 2 顆,L3 快取則由 12MB 降至 6MB。記憶體部分,最高容量從 96GB 調整為 64GB DDR5,介面寬度由 128-bit 縮至 64-bit,Memory-side Cache 也從 8MB 減為 4MB。
其他功能同樣依照主流市場需求重新取捨,包括移除相機介面,媒體引擎從支援 8K60、VVC 解碼與完整影像效果,調整為最高 4K60 與 HDR 效果;顯示輸出能力則由 4 組 UHBR20 改為 3 組 HBR3。這一系列調整可讓 Compute Die 面積減少約 38%。換句話說,Wildcat Lake 的成本策略並不是把既有高階晶片單純「降頻降規」,而是從核心、GPU、NPU、記憶體到多媒體功能重新配置 IP 數量與 SoC 面積,讓整體設計更貼近主流 PC 的實際需求。
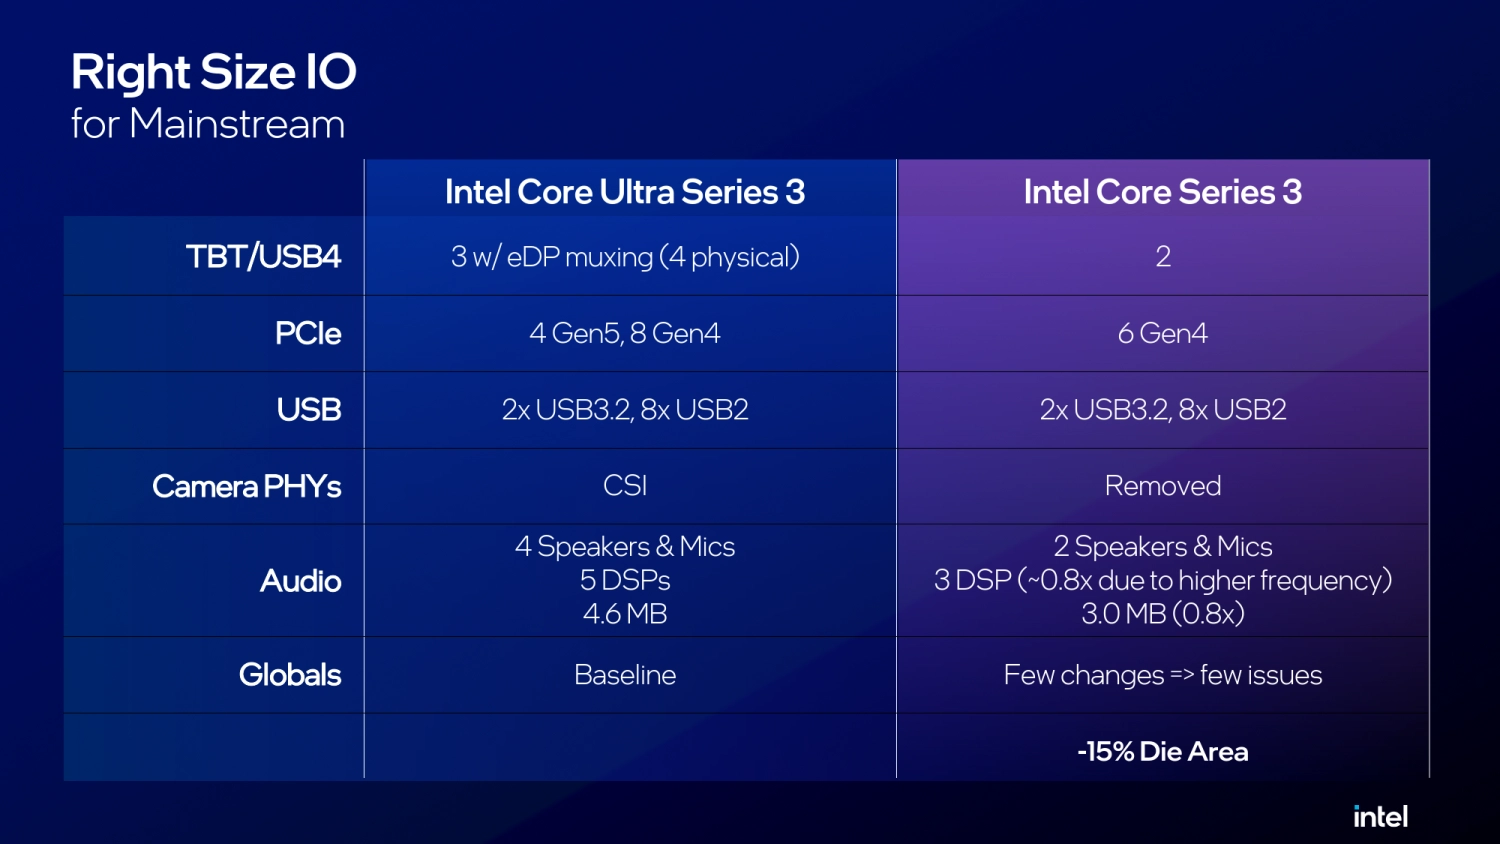
I/O 部分同樣延續「夠用就好」的設計思路。Core Series 3 保留 2 組 Thunderbolt 4、6 條 PCIe Gen4、2 組 USB 3.2 與 8 組 USB 2.0,同時取消 Camera PHY,音訊 DSP 規模也有所縮減,這些調整可進一步減少約 15% 的 I/O Die 面積。
從高階玩家的角度來看,這樣的 I/O 配置顯然不是追求規格堆疊,而是針對主流市場重新取捨。對教育、商用、小型企業與入門筆電而言,Intel 的考量是避免為使用率較低的 PCIe 通道、Camera PHY 或高階顯示輸出能力,而增加額外晶片面積與主機板成本,將資源集中在日常使用更需要的功能上。
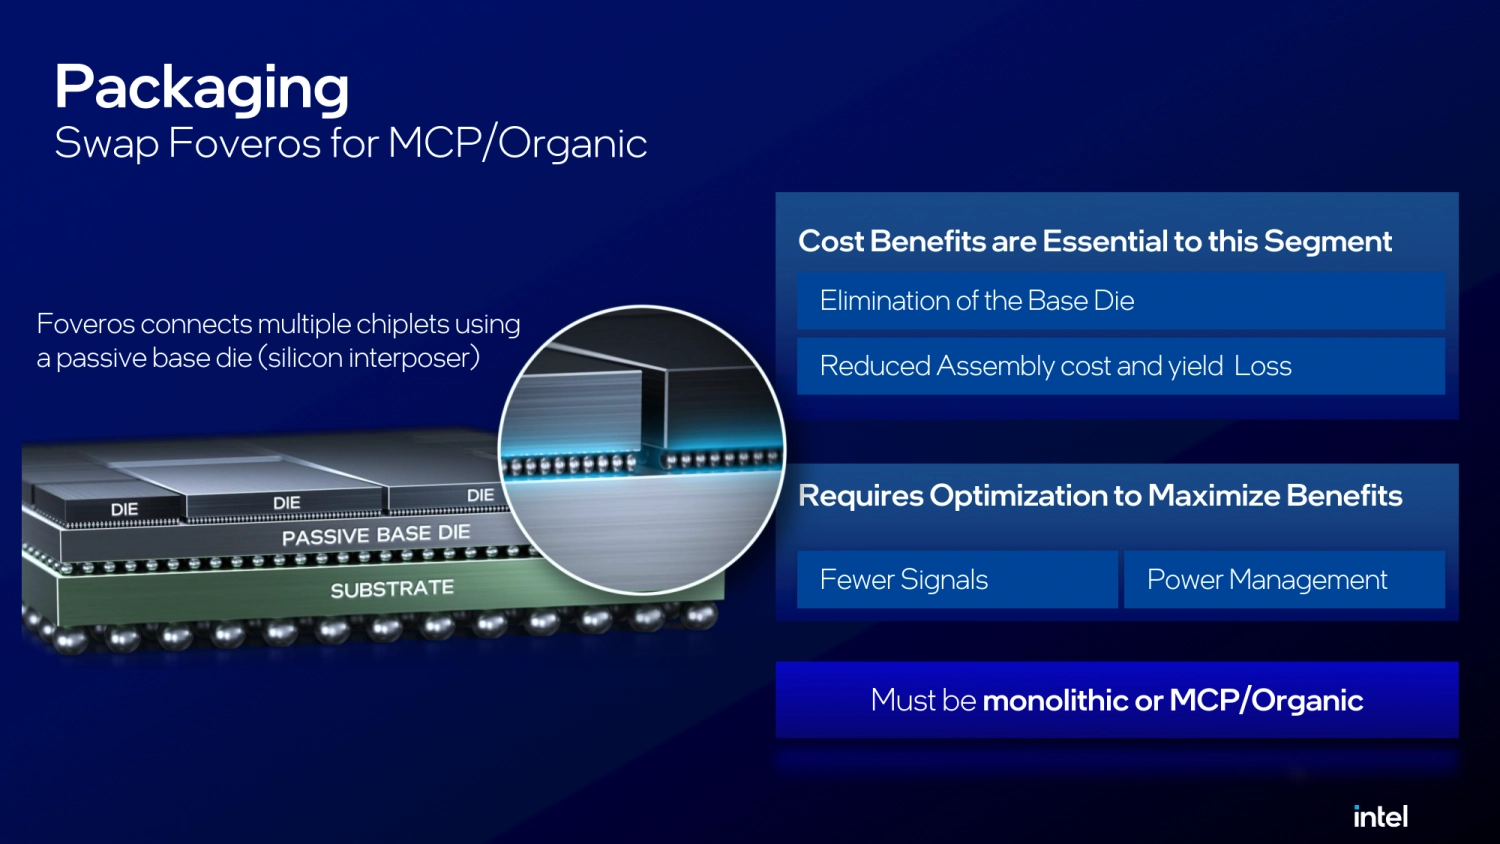
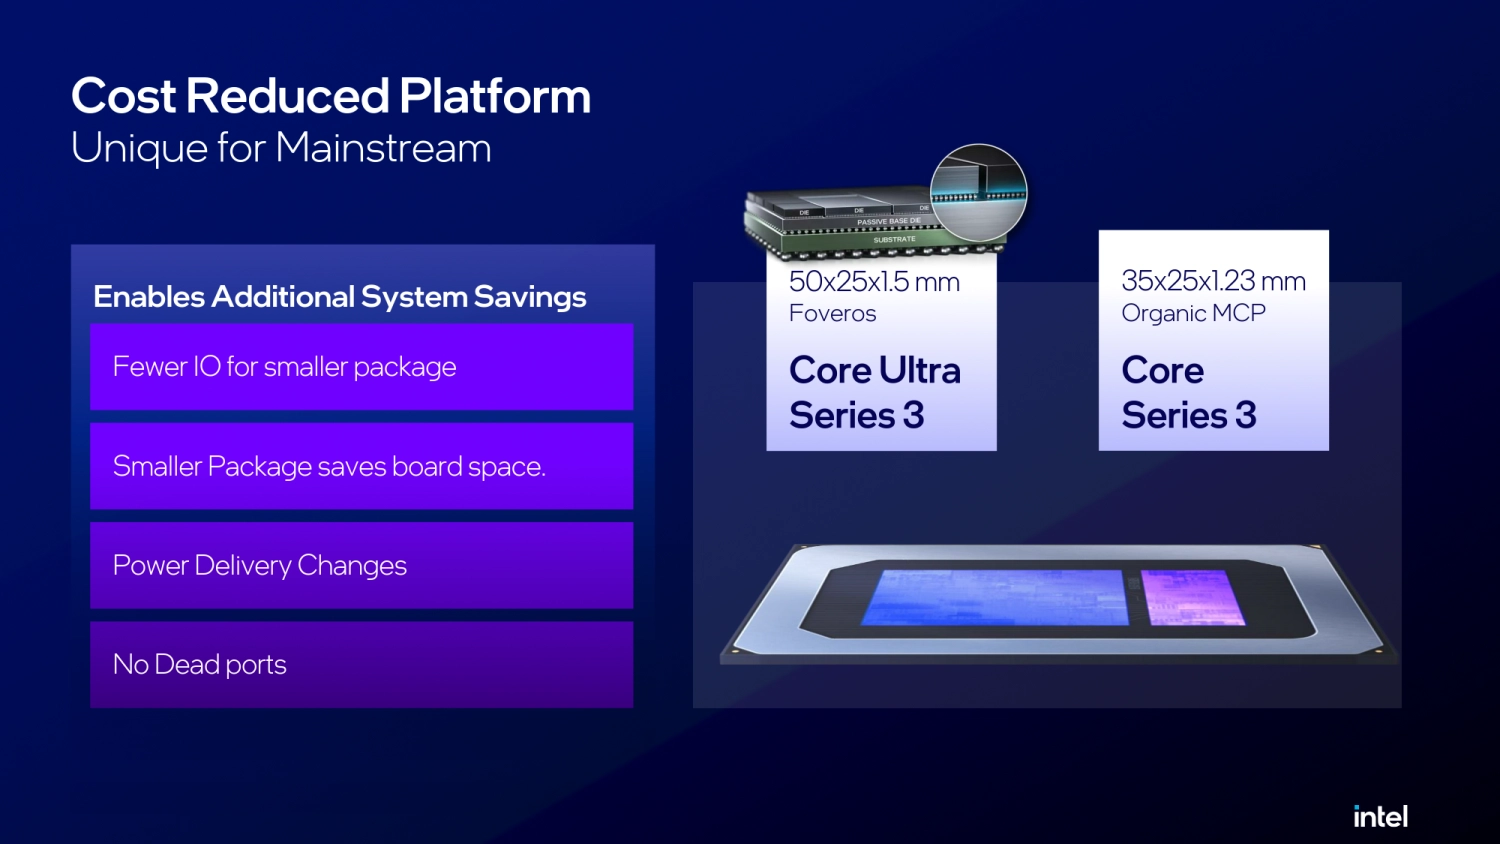
更關鍵的改變,則出現在封裝與整體平台設計。Panther Lake 採用 Foveros 封裝,透過 passive base die 連接多個 chiplet;Wildcat Lake 則改為成本更低的雙晶片 Organic MCP。Intel 表示,取消 base die 不僅有助於降低組裝成本,也能減少封裝良率損失,同時進一步縮小處理器封裝體積。相較 Core Ultra Series 3 的 50 × 25 × 1.5 mm,Core Series 3 封裝尺寸縮減至 35 × 25 × 1.23 mm。
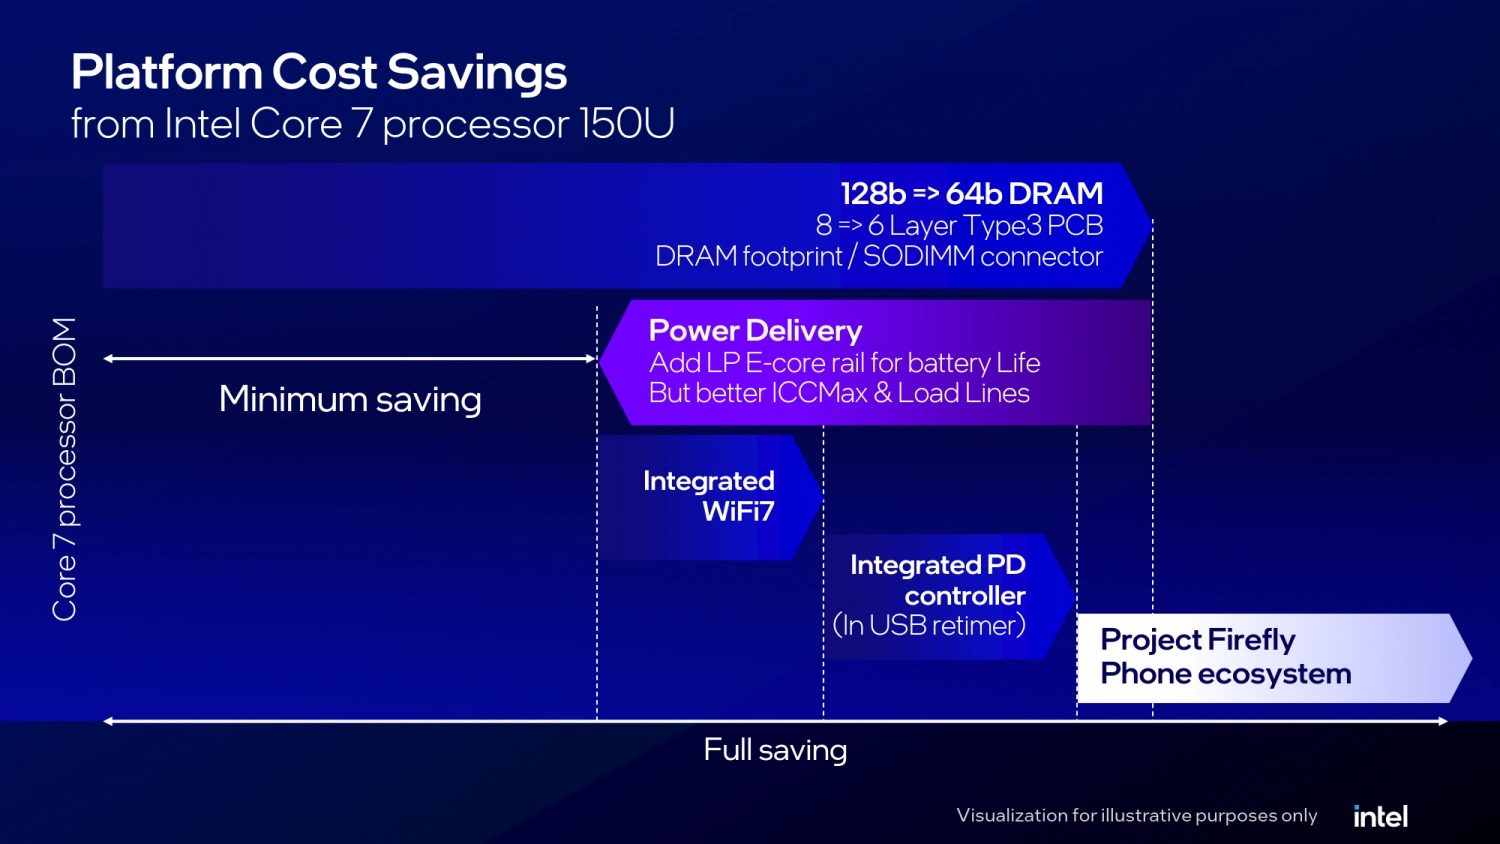
平台端也同步朝降低整機成本的方向調整,包括將記憶體介面由 128-bit 縮減為 64-bit,並支援成本較低的 6 層 Type-3 PCB;儲存裝置方面,OEM 也可依產品定位選擇 UFS 3.0 或 PCIe Gen4 SSD。整體來看,Wildcat Lake 並非只縮減單一規格,而是從封裝、記憶體到主機板與儲存配置全面重新設計,以降低主流筆電的整體 BOM 成本。
改用 Organic MCP 之後,Wildcat Lake 也必須重新處理 die-to-die 互連問題,因此成為 Intel 首款實際產品化導入 UCIe 的 Core 處理器。Foveros 原本採用約 36μm bump pitch,而 UCIe 在 Organic MCP 上則放大至約 110μm,更大的間距意味著必須透過更高的資料傳輸率來補足頻寬,同時也會增加 I/O Controller 的面積需求。
Intel 最終將 Wildcat Lake 的 UCIe 連線設定在最高 8GT/s,並以約 12GB/s 作為 PCIe 4.0 SSD 路徑的設計目標,同時將大量 sideband 訊號改為封包化傳輸。由於 UCIe 介面不只負責一般資料交換,還會牽涉 Boot、Debug、Security 與 Display 等協定,因此 Intel 也坦言,這部分成為 Wildcat Lake 開發過程中驗證工作最密集的區域之一。
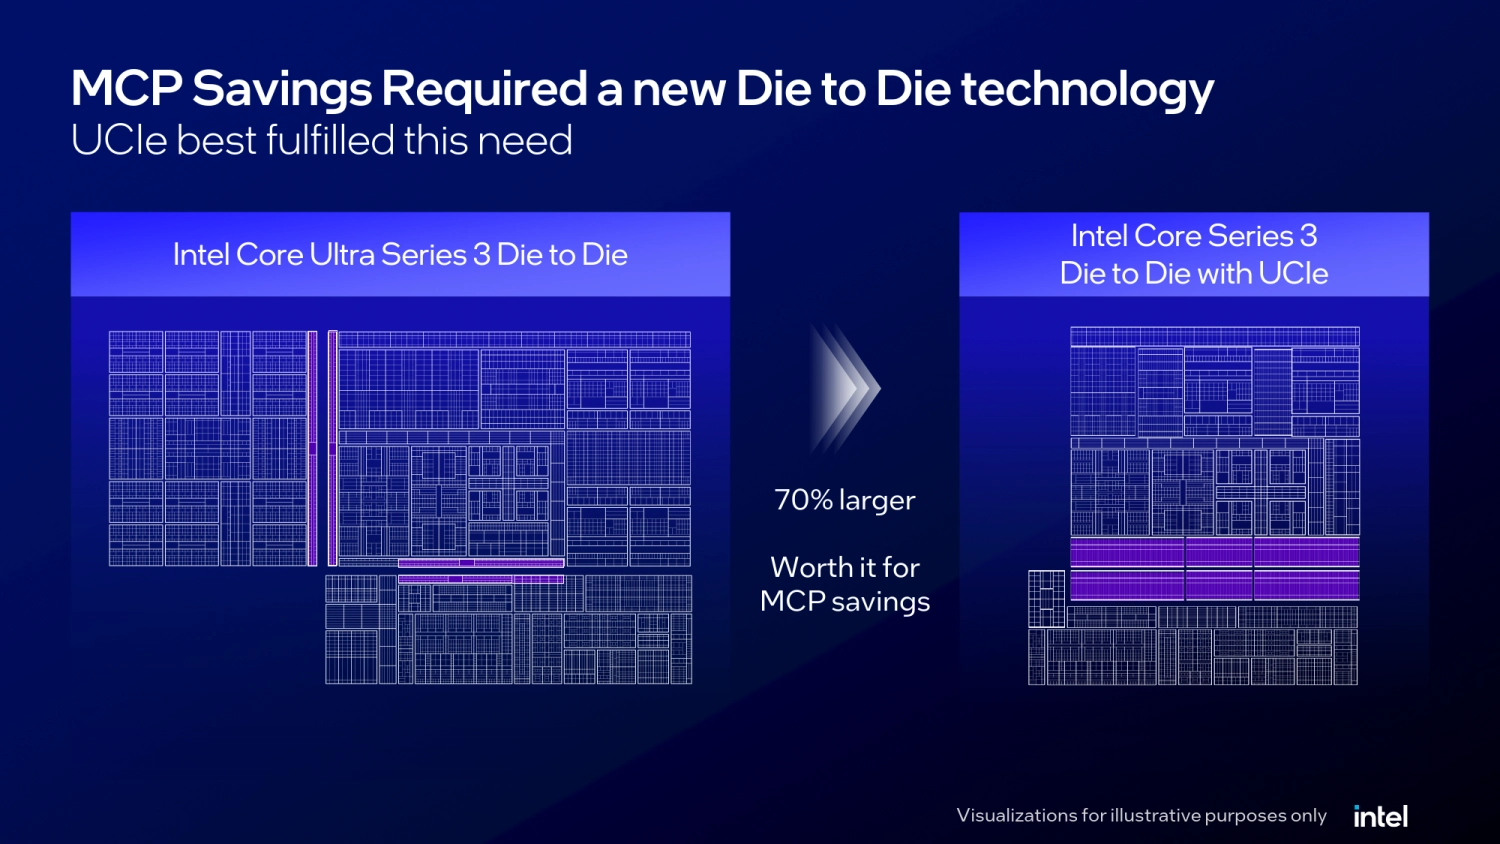
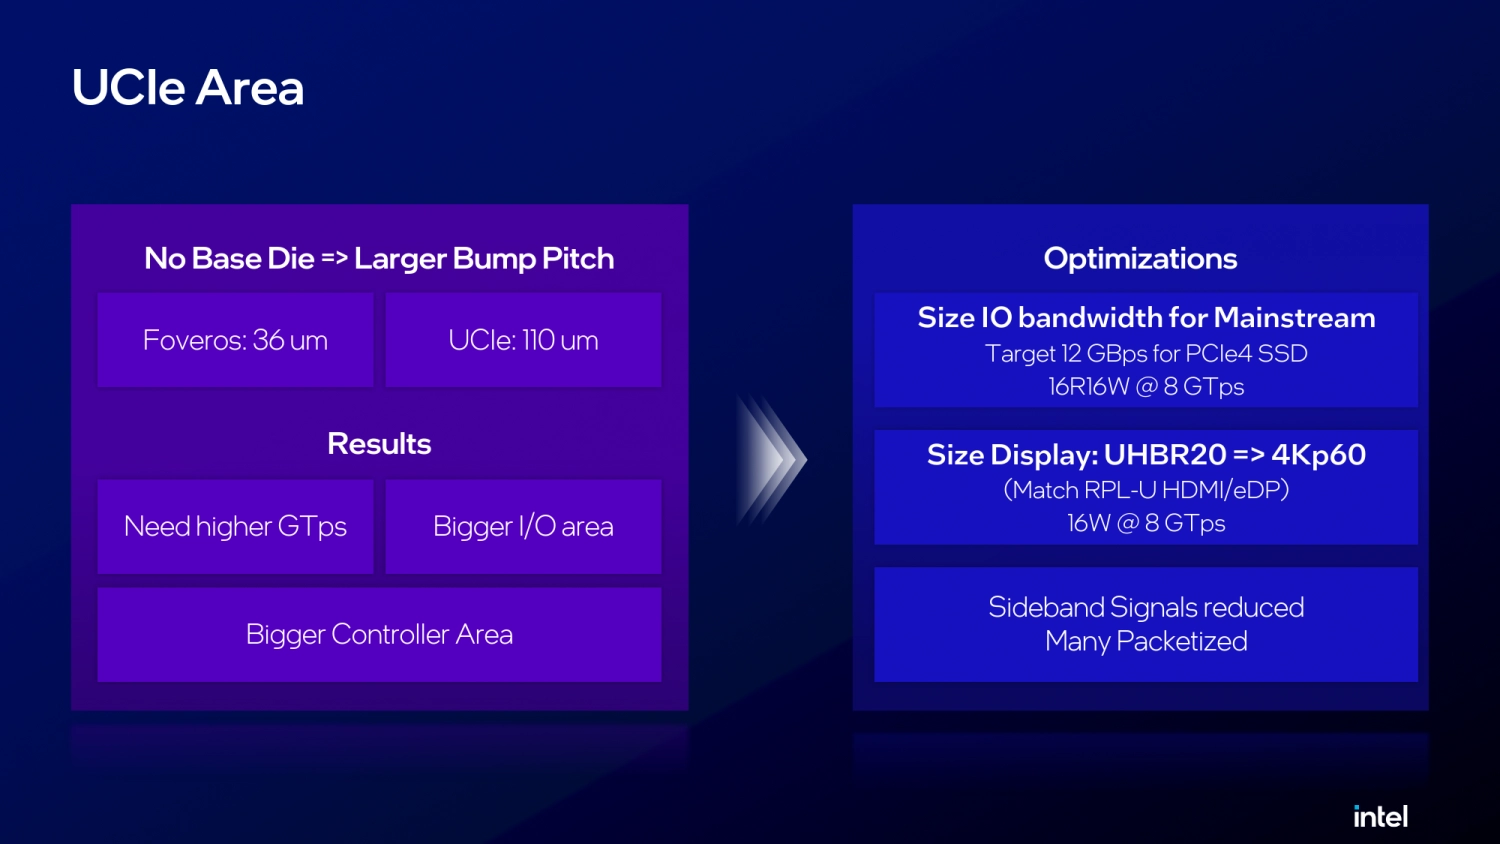
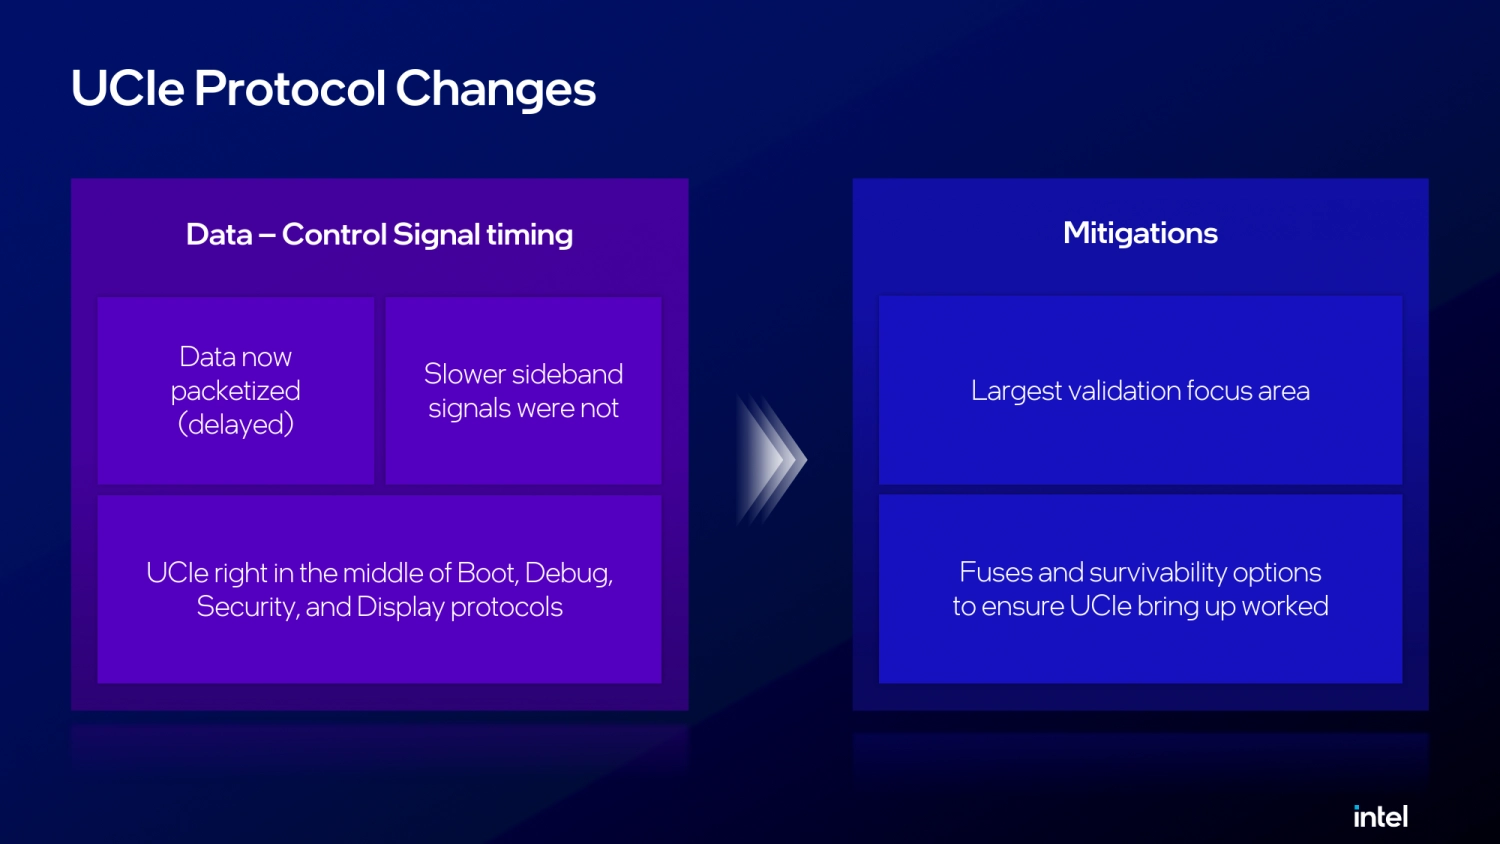
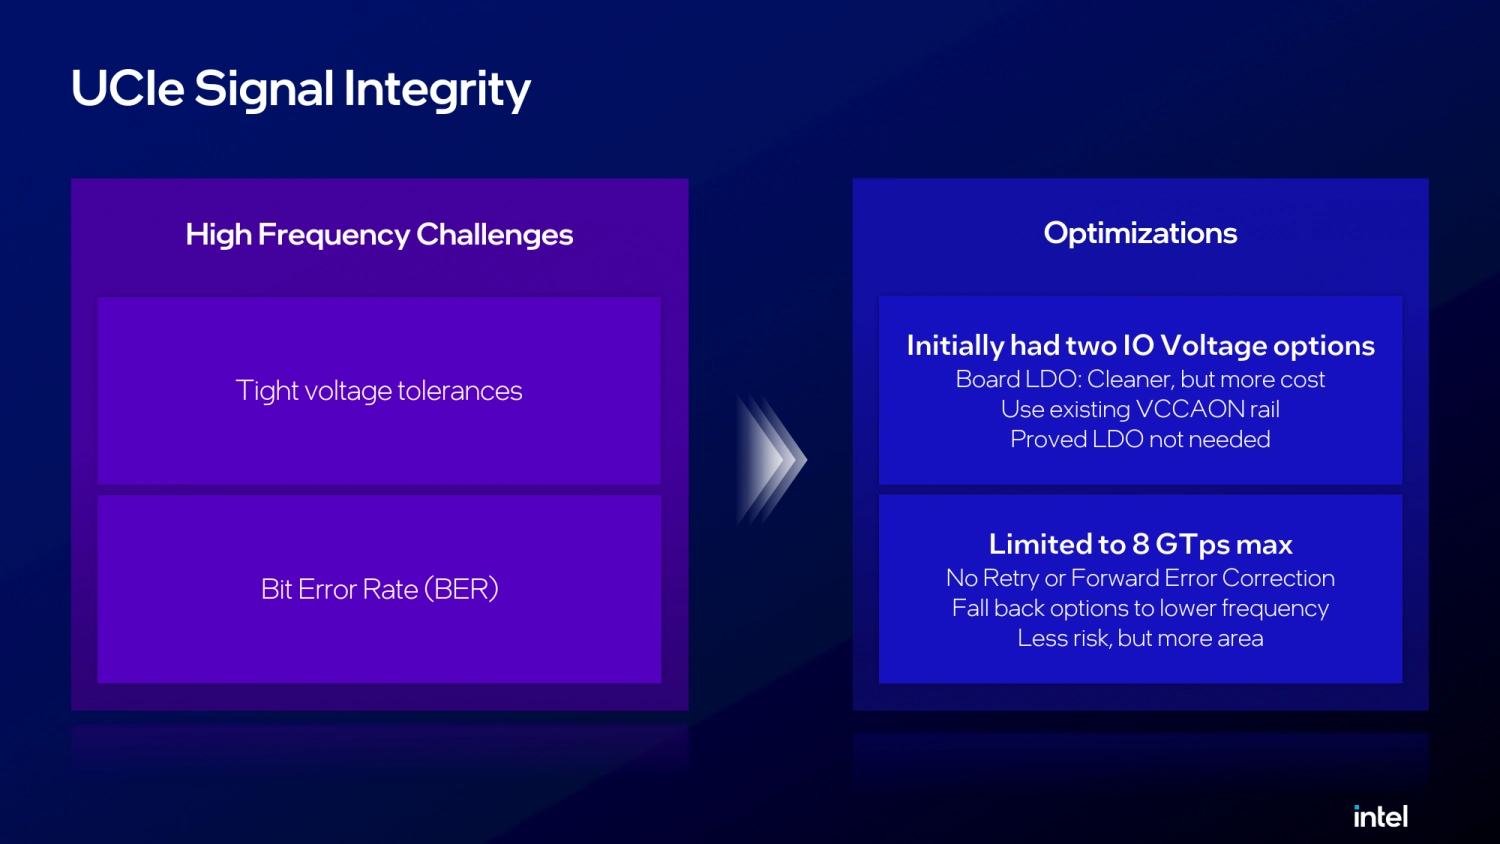
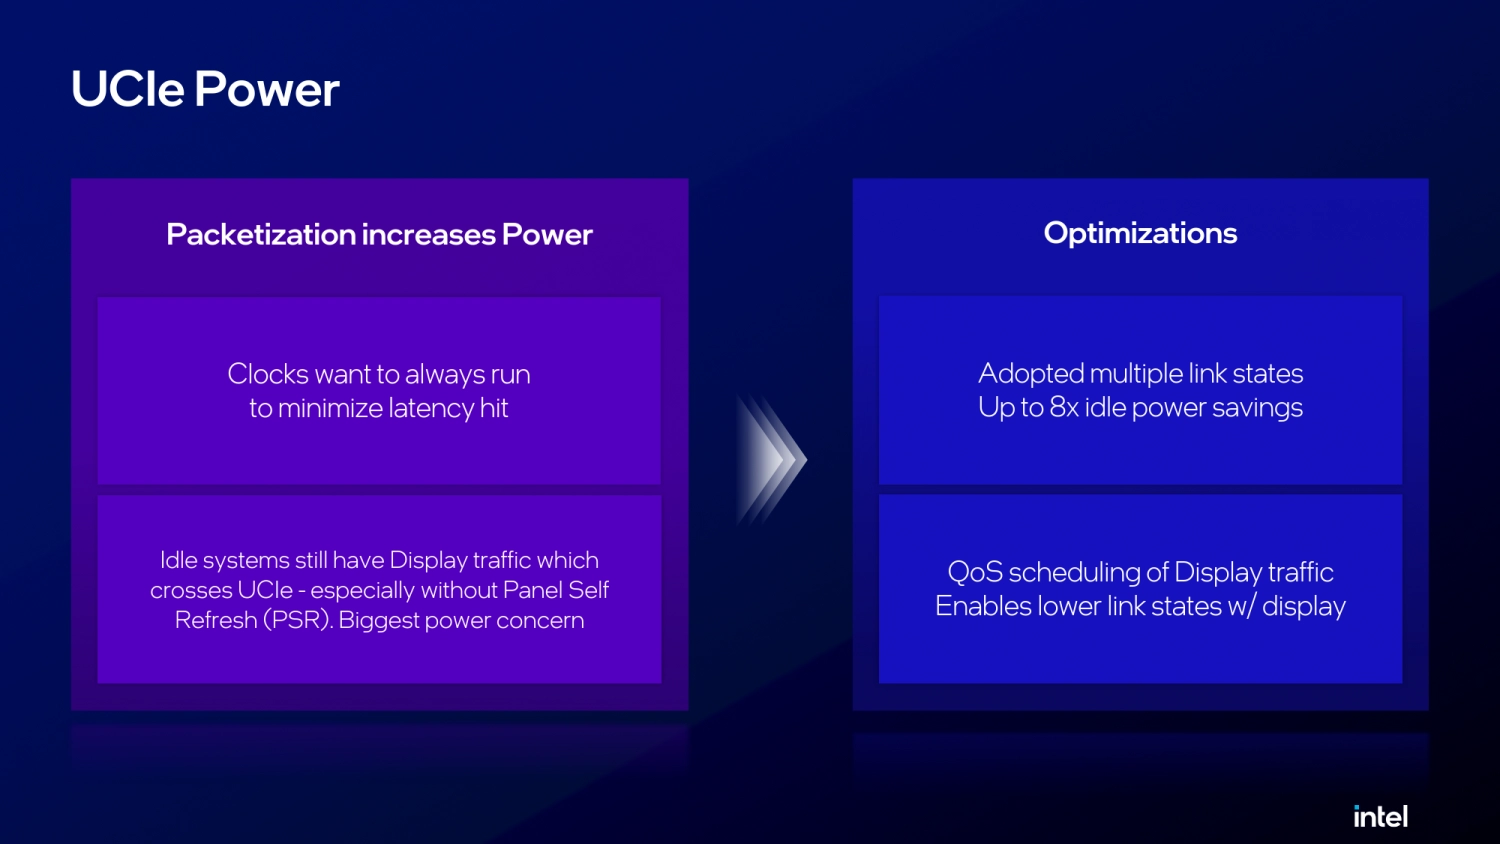
對主流筆電而言,UCIe 帶來的一項重要挑戰其實是功耗。由於資料封包化後,為了降低傳輸延遲,相關時脈傾向維持運作;即使系統處於閒置狀態,顯示資料仍可能持續穿越 UCIe,成為額外的待機功耗來源。
為此,Intel 在 Wildcat Lake 中導入多種 UCIe Link State,並宣稱可將閒置狀態下的 Link Power 最多降低至原本的八分之一;同時透過 Display QoS 排程機制管理顯示流量,讓 UCIe 即使仍有顯示資料傳輸,也能盡可能進入較低功耗的連線狀態。這項設計也說明,Wildcat Lake 所強調的「全天候電池續航」並非單靠 Intel 18A 製程達成,而是從晶片製程、封裝互連到系統層級功耗管理共同最佳化的結果。
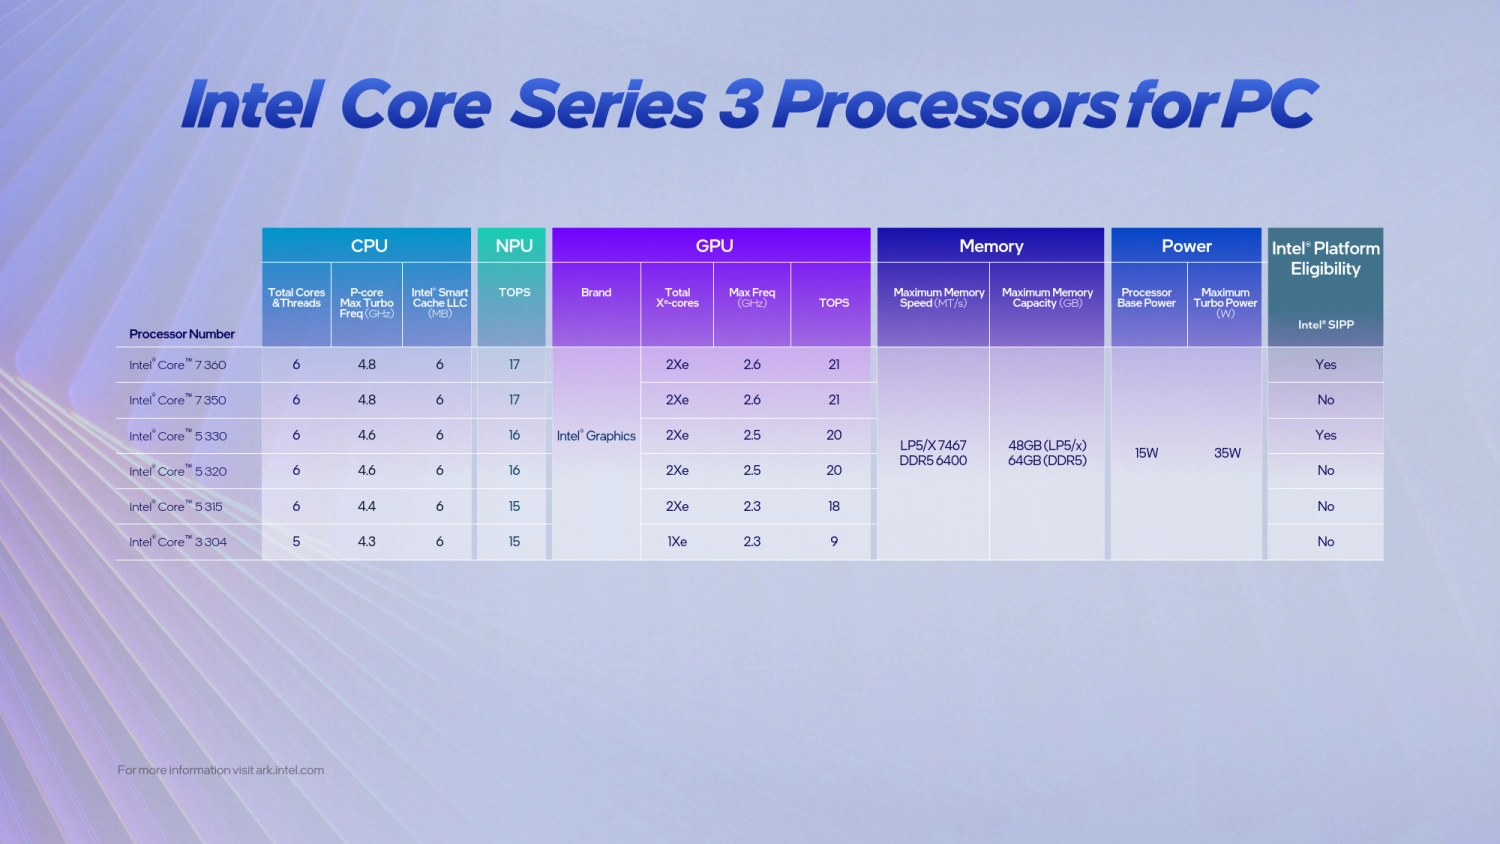
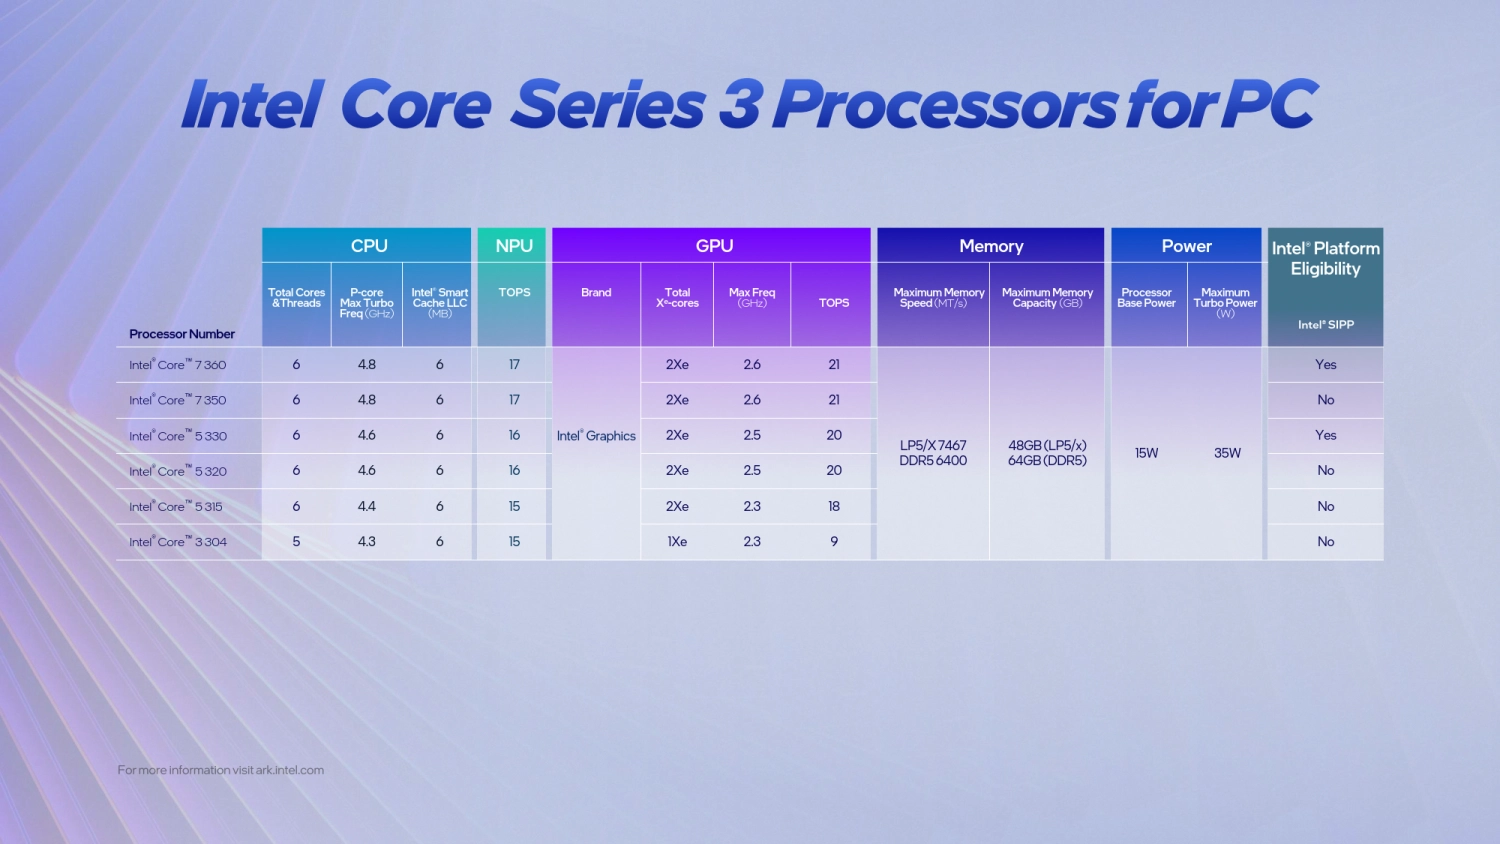
Wildcat Lake 首波產品線共包含六款型號,分別為 Core 7 360、Core 7 350、Core 5 330、Core 5 320、Core 5 315 與 Core 3 304。除了 Core 3 304 採 5 核心、1 組 Xe Core 配置外,其餘五款均為 6 核心設計。
其中 Core 7 系列的 P-core 最高 Turbo 時脈可達 4.8GHz,NPU 算力最高 17 TOPS,GPU 算力則為 21 TOPS;Core 5 系列則依型號不同,P-core 最高時脈為 4.6GHz 或 4.4GHz,NPU 算力介於 15~16 TOPS。全系列 Processor Base Power 均為 15W,Maximum Turbo Power 為 35W;記憶體則支援 LPDDR5X-7467,最高容量 48GB,或 DDR5-6400,最高可擴充至 64GB。
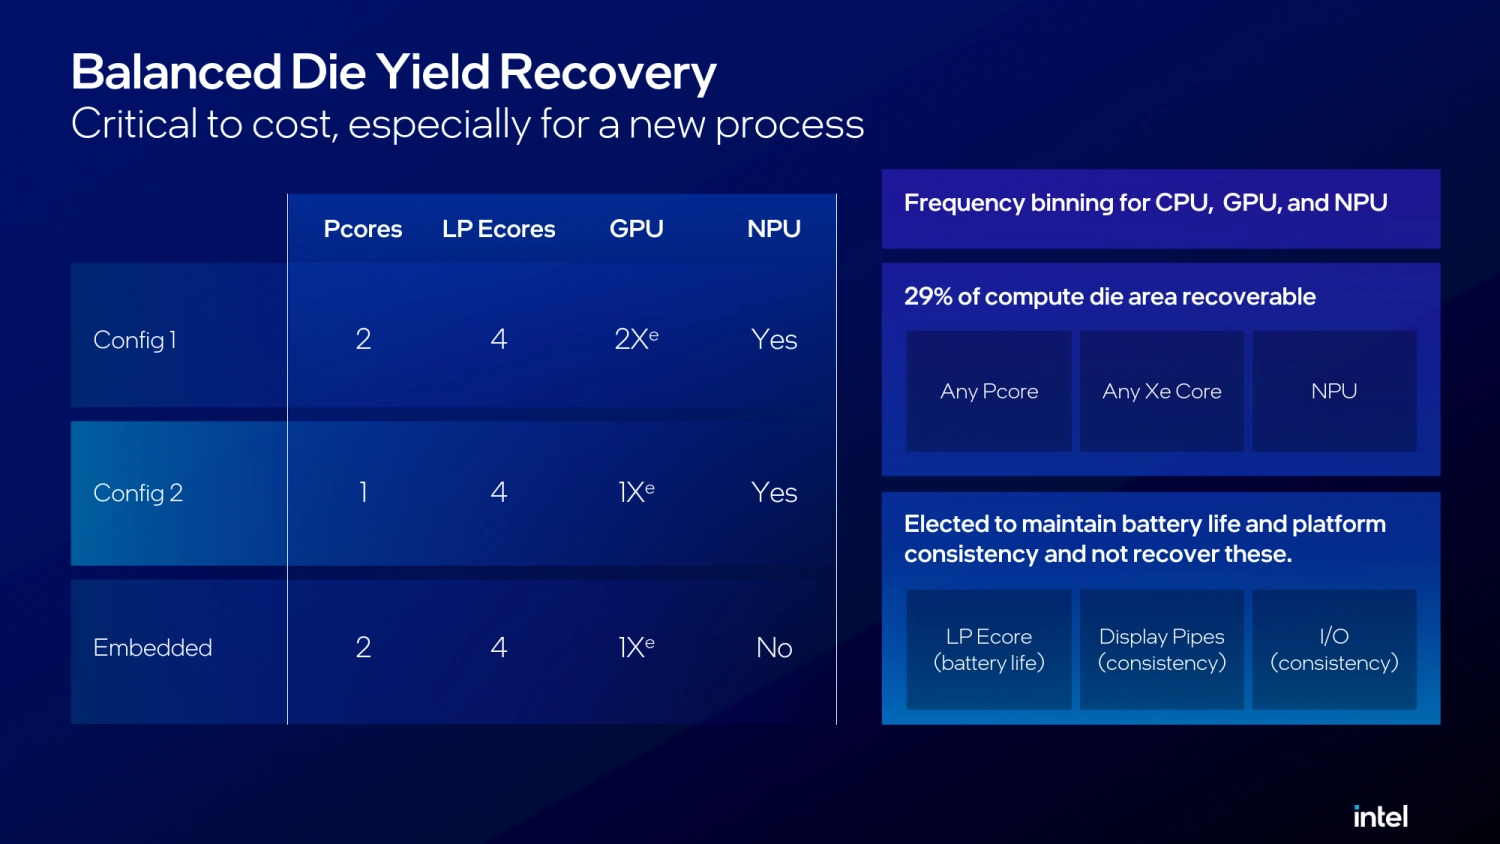
Intel 也為 Wildcat Lake 預留了相當明確的 Binning 與良率回收空間,Compute Die 可根據 P-core、Xe Core 與 NPU 的實際良率狀況,透過不同 SKU 配置進行降級利用,約有 29% 的 Compute Die 面積可藉由這種方式回收。不過,LP E-core、Display Pipes 與 I/O 則刻意不納入降級範圍,以維持電池續航表現與不同產品之間的平台一致性。
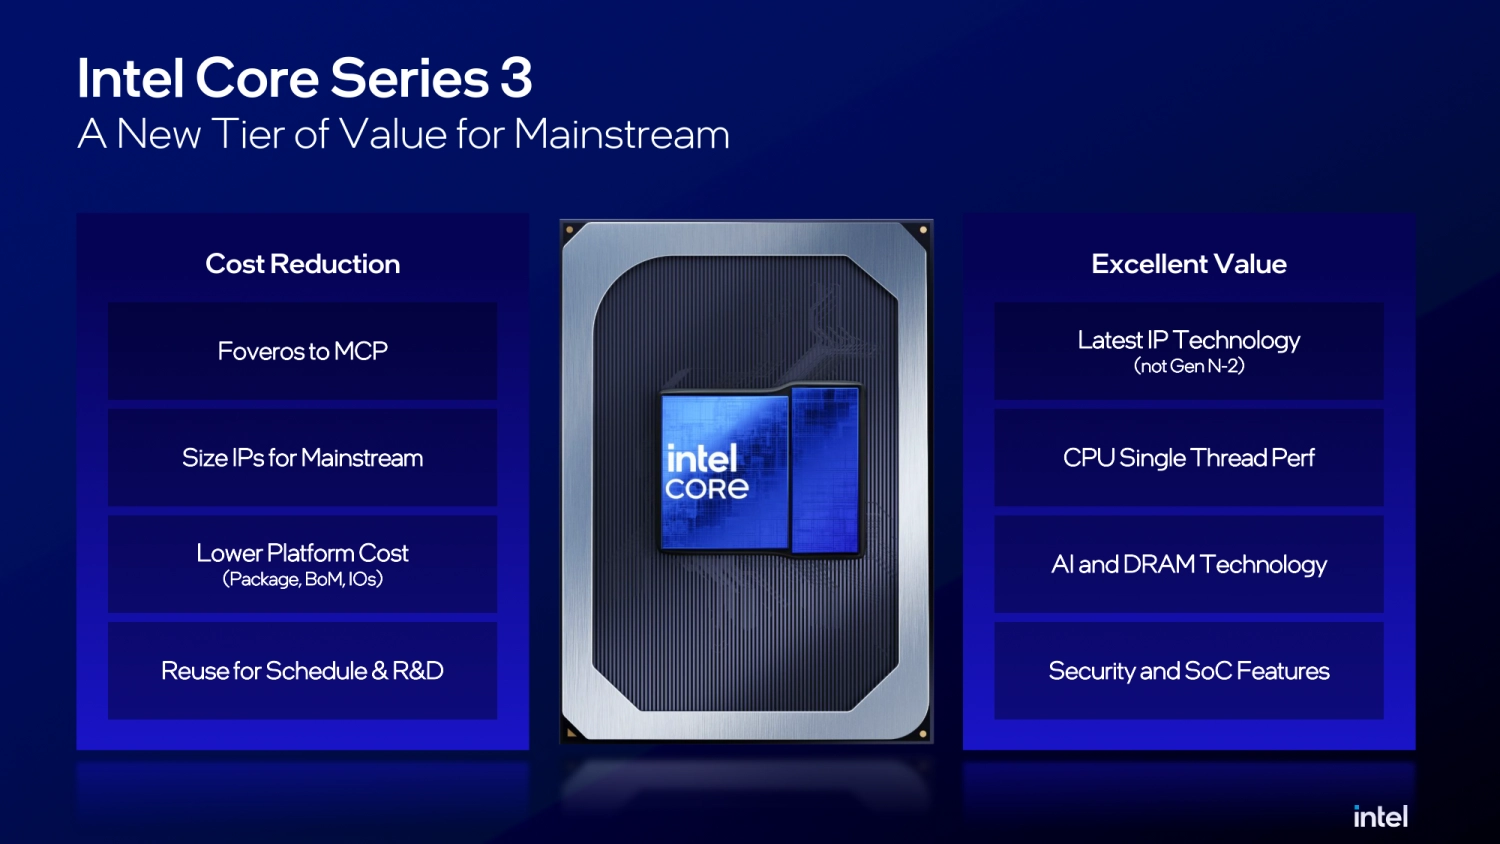
這也進一步反映出 Wildcat Lake 的成本策略。面對 Intel 18A 新製程帶來的製造成本,Intel 並不是只靠單一手段壓低價格,而是同時透過 Organic MCP、縮小 Die 面積、精簡 I/O,以及 SKU Binning 等方式,降低整體平台成本並提高可用晶片比例。換句話說,Wildcat Lake 的設計不只是在做產品分級,也是在從架構層面提高新製程下的良率利用效率。
Crescent Island:重寫 AI 推論成本
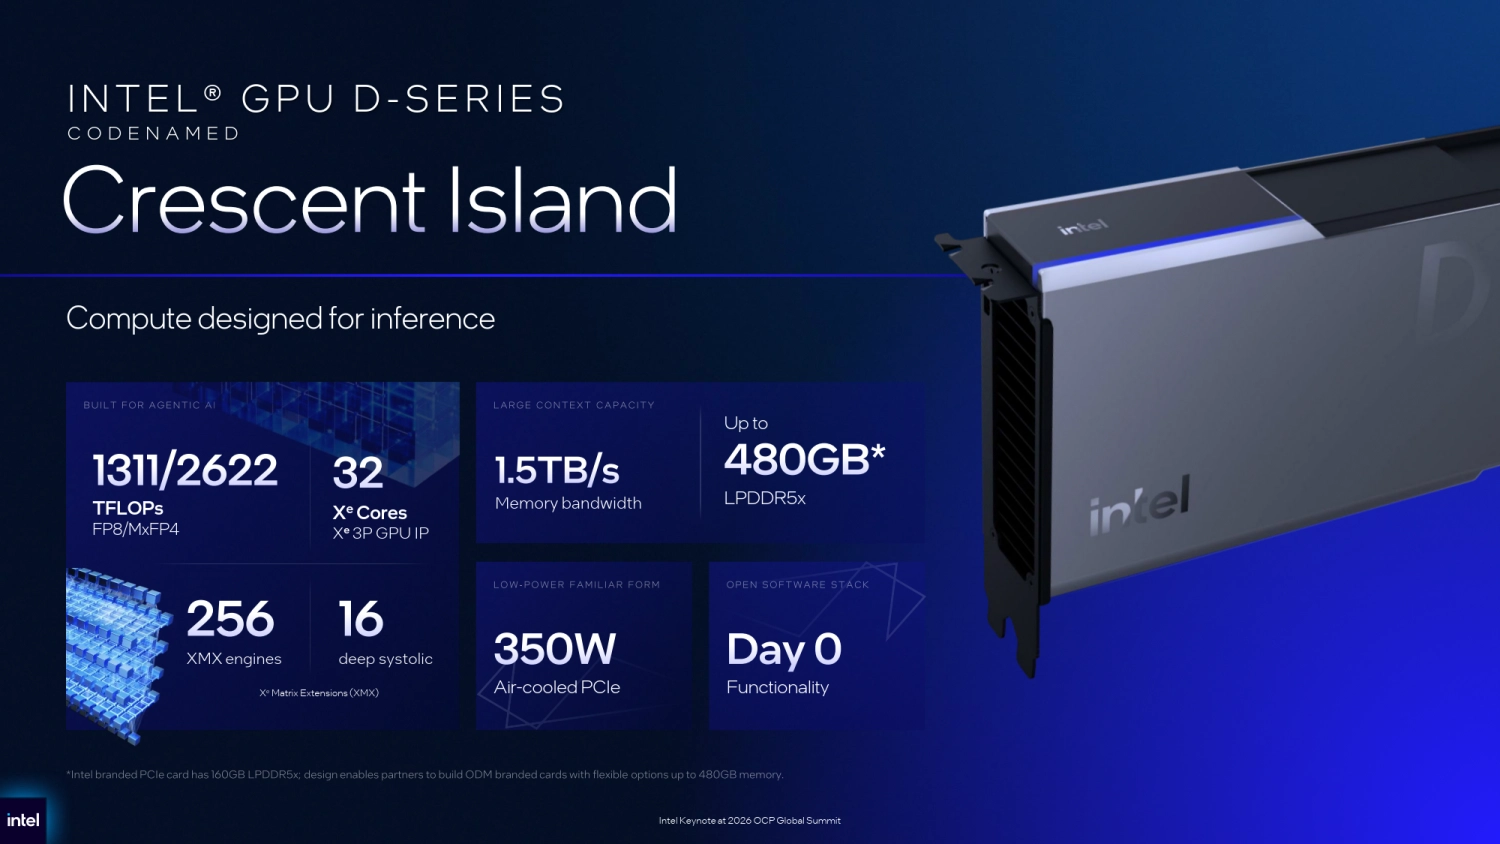
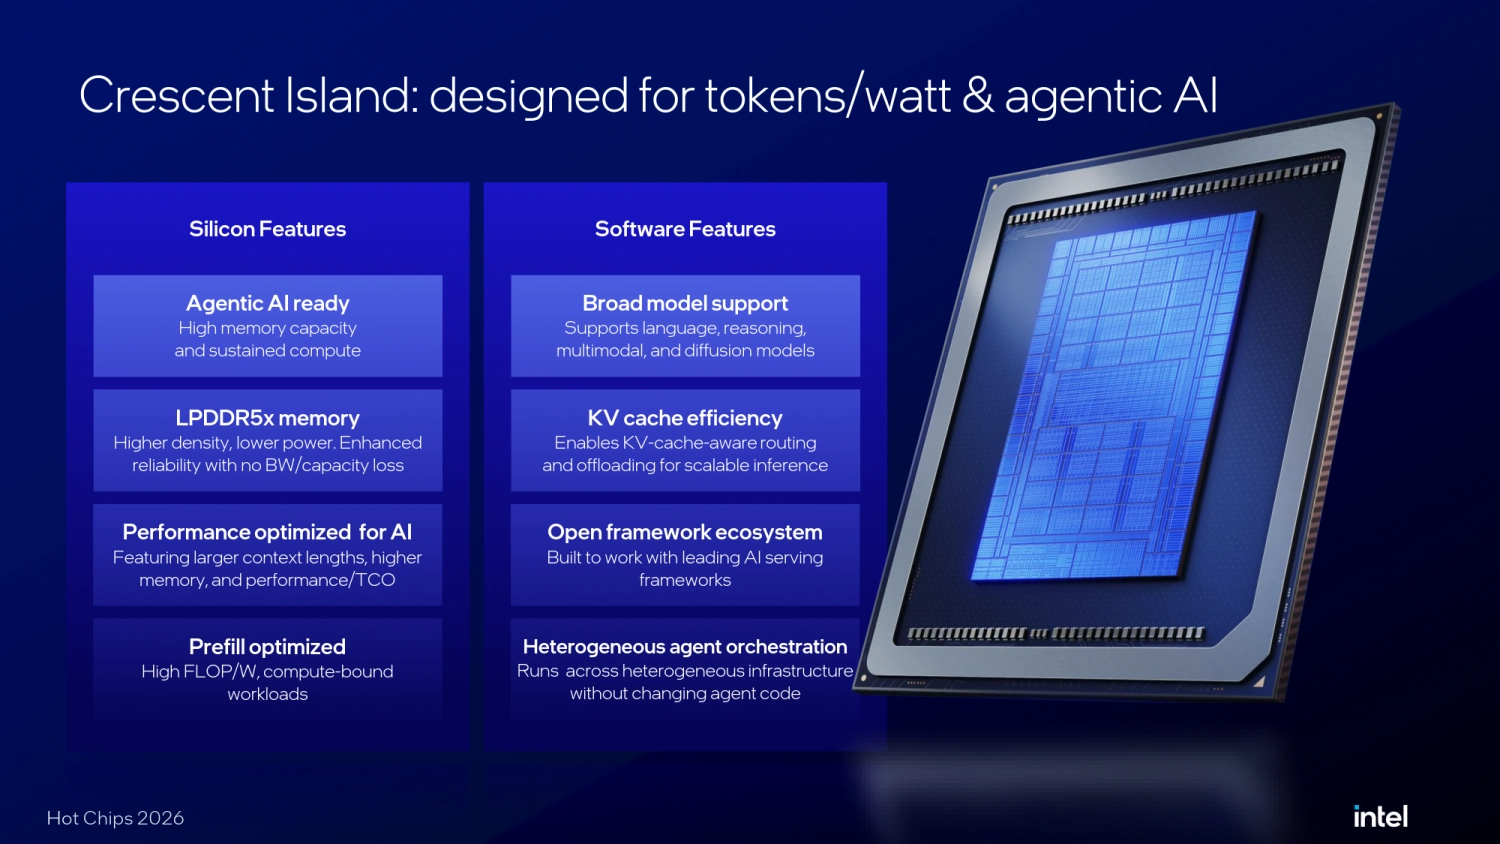
Crescent Island 已從早期架構代號逐步演進為 Intel GPU D-series,而 Intel 官網目前也進一步以 Intel GPU D270 作為對外產品名稱。這款 GPU 的設計重點並非追求大型模型訓練所需的極致峰值 FLOPS,而是明確鎖定 Agentic AI 推論工作負載,強調記憶體容量、運算效率與部署彈性之間的平衡。
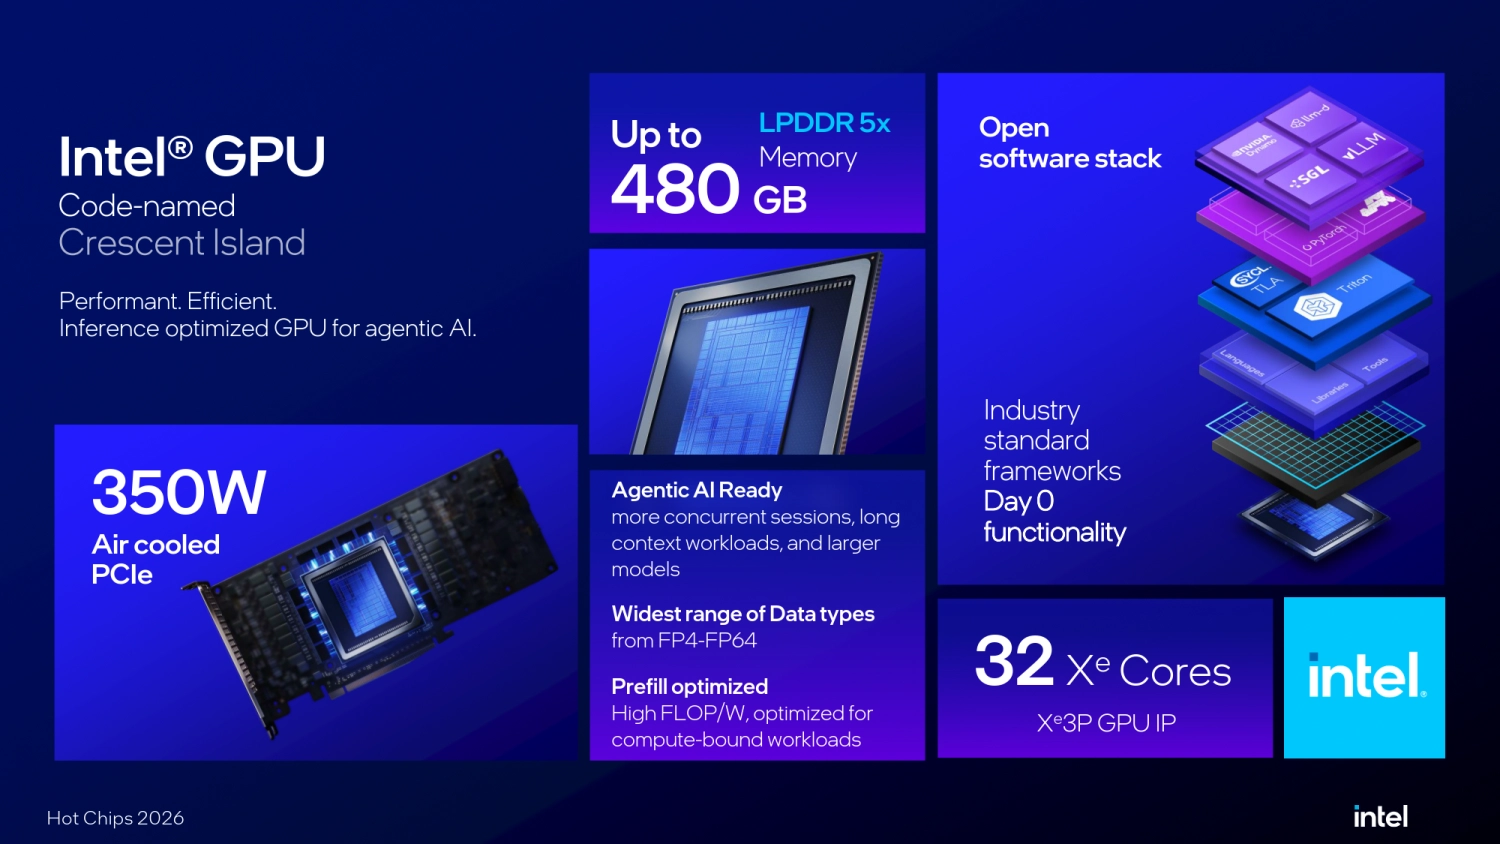
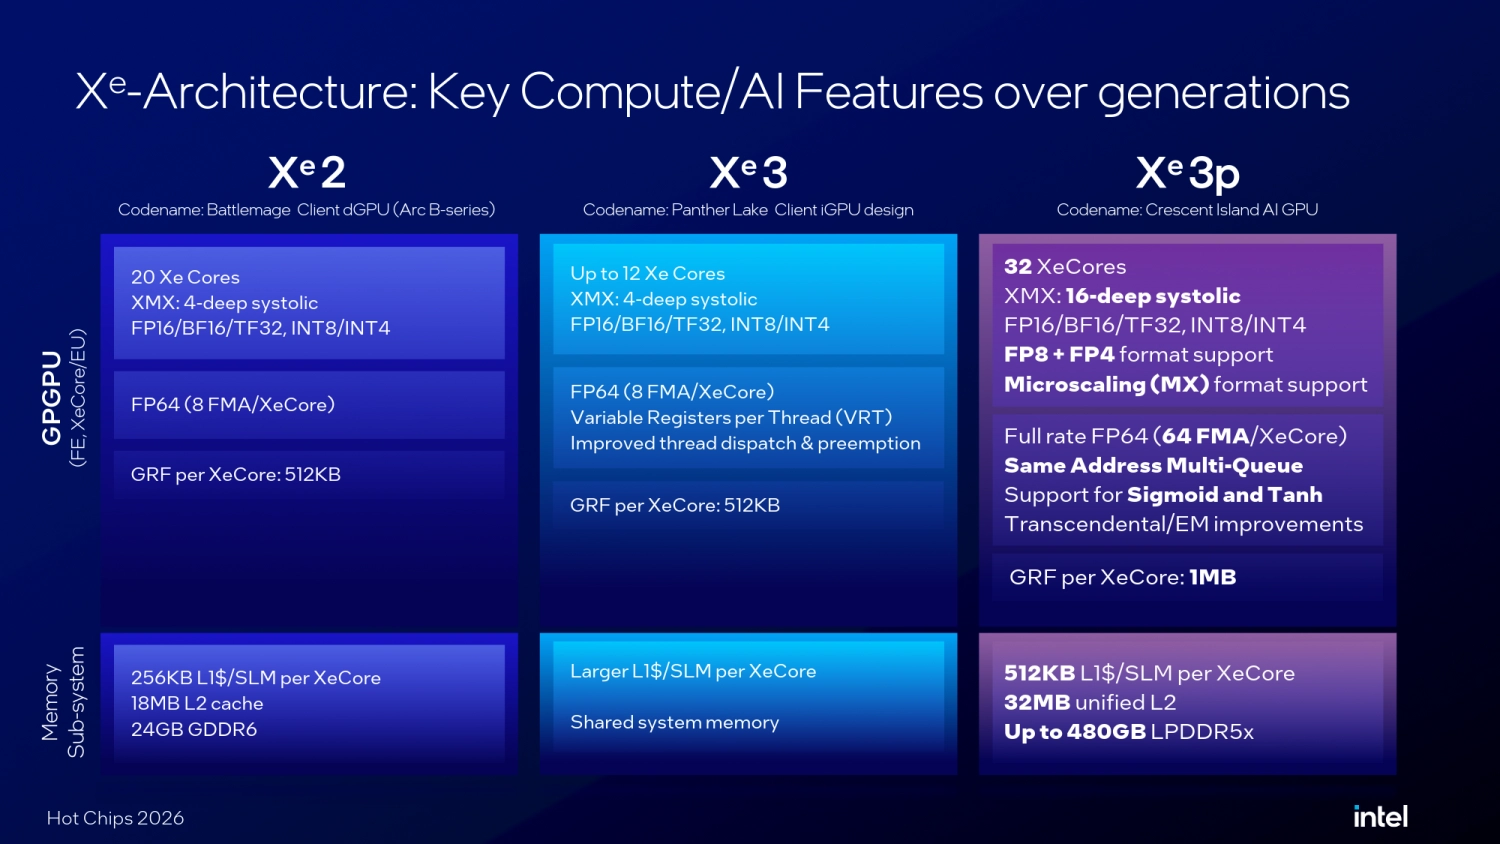
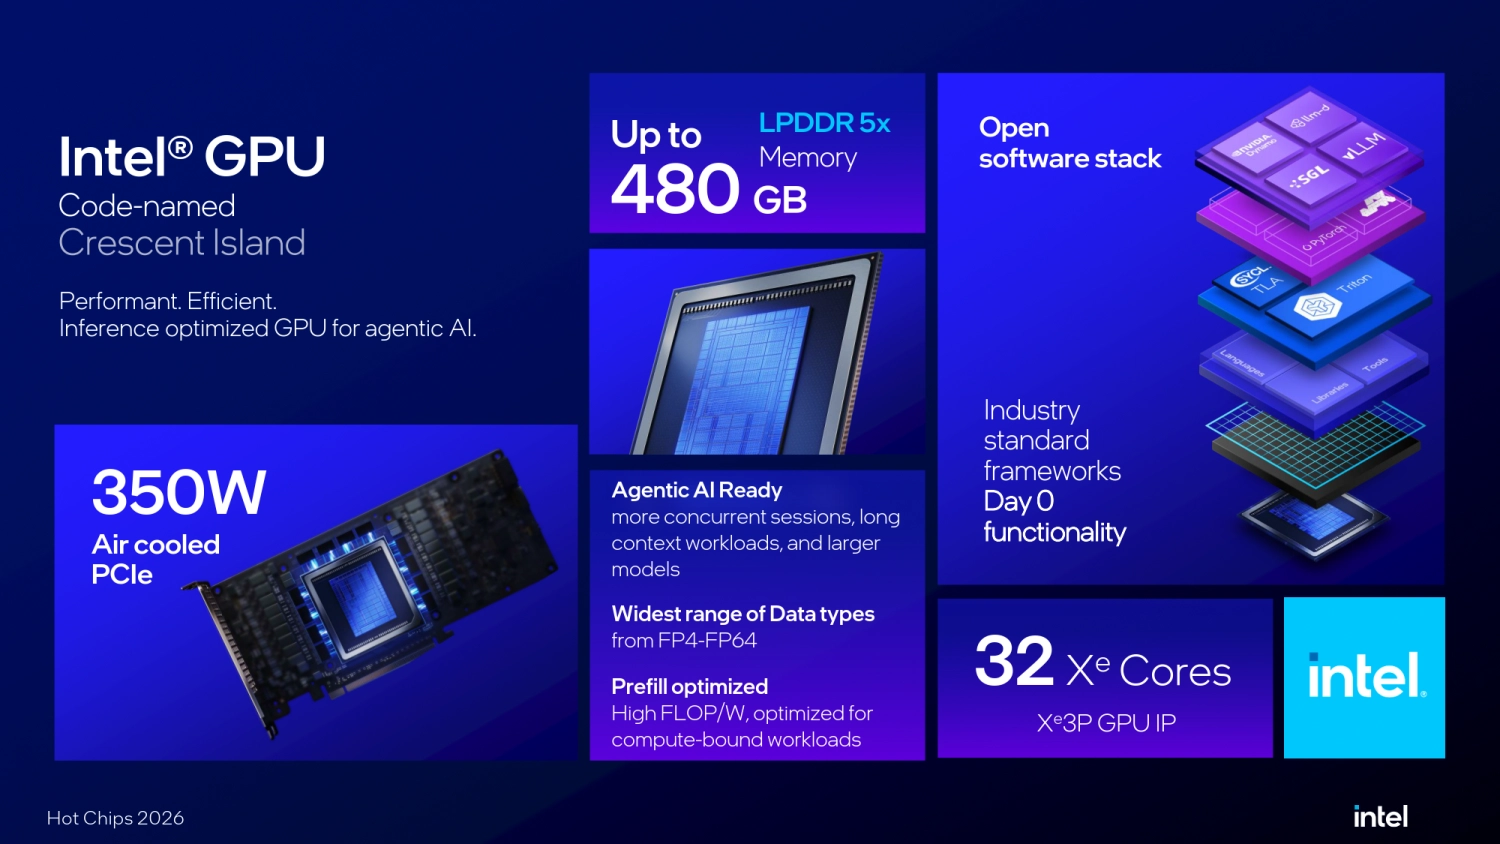
D270 採用 32 個 Xe3P Xe Core、256 個 XMX Matrix Engine,FP8 運算效能約 1.3 PFLOPS,記憶體配置最高可達 480GB LPDDR5X,頻寬為 1.5TB/s,整卡功耗則控制在 350W,並採用標準 PCIe 介面與風冷式設計,方便直接導入既有資料中心環境。
不過,「最高 480GB」這項規格需要特別說明。Intel 指出,自有品牌顯示卡的 LPDDR5X 容量為 160GB,而 480GB 代表平台設計可提供 ODM 夥伴更高容量的配置彈性。因此,480GB 並非所有 Intel GPU D270 產品的標準記憶體容量,而是整體平台架構所支援的最高設計上限。
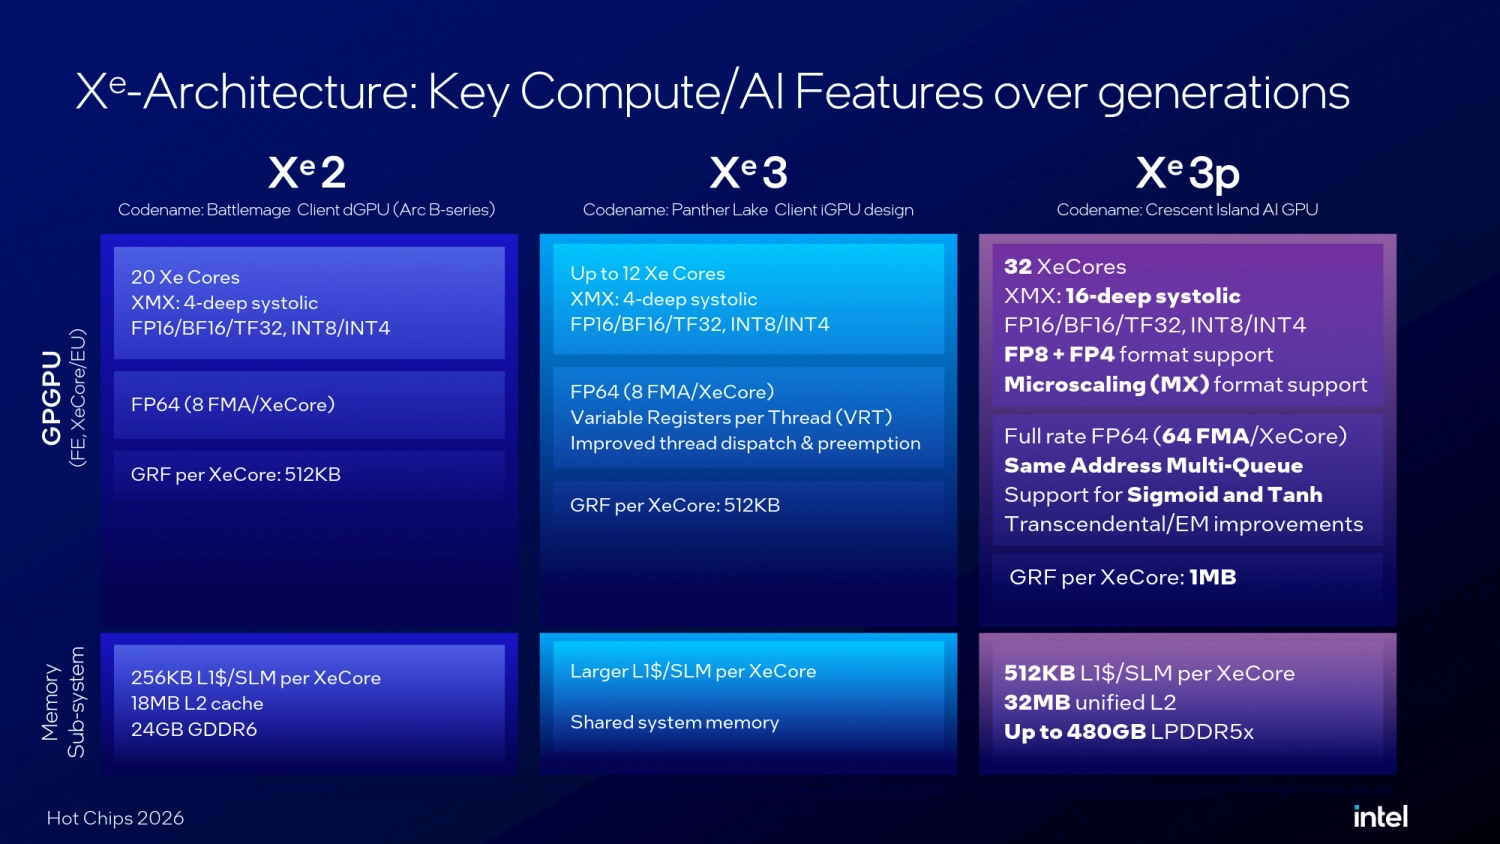
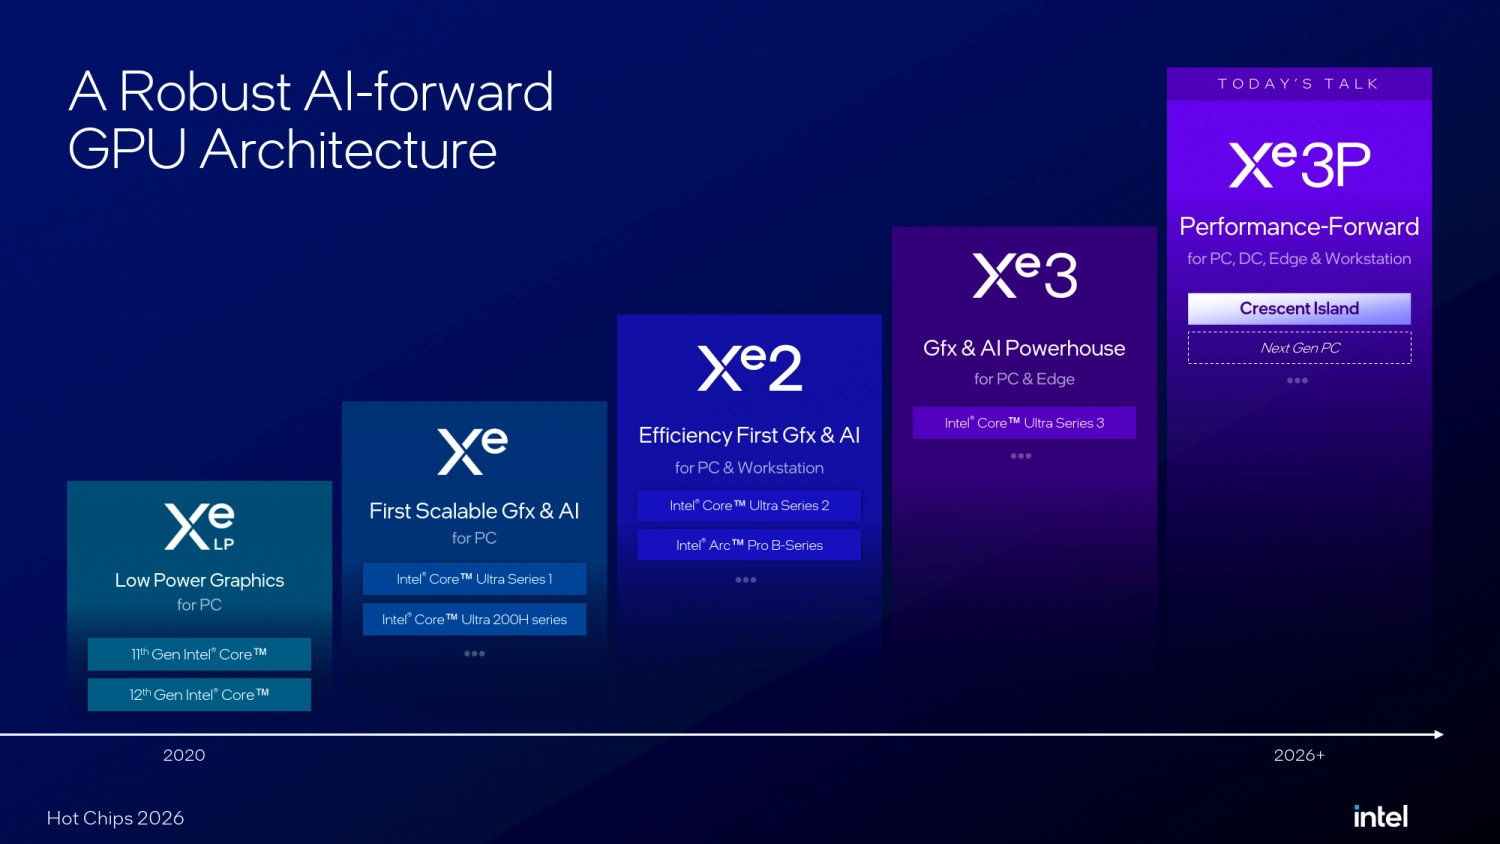
Xe3P 與 PC 端 Xe3 的設計取向有明顯差異。針對資料中心 AI 推論需求,Xe3P 將 XMX 的 systolic depth 從 Xe3 的 4-deep 提升至 16-deep,並新增 FP8、FP4 與 Microscaling 等低精度資料格式支援;FP64 也提升至 full-rate 64 FMA / Xe Core,同時加入 Same Address Multi-Queue,以及 Sigmoid、Tanh 等超越函數運算強化。
在核心內部資源方面,每個 Xe Core 的 GRF 容量也由 512KB 增加至 1MB,L1 / SLM 擴大至 512KB,並搭配 32MB unified L2。這些變化顯示,Xe3P 並不是單純將 PC 端 Xe3 放大,而是從矩陣運算能力、暫存資源到資料路徑,都重新偏向 AI 與資料中心推論工作負載最佳化。Intel 也指出,D270 將部分原本用於 graphics 與 ray tracing pipeline 的 die area,重新配置給 Xe3P 與 matrix compute,以強化其推論導向的架構定位。
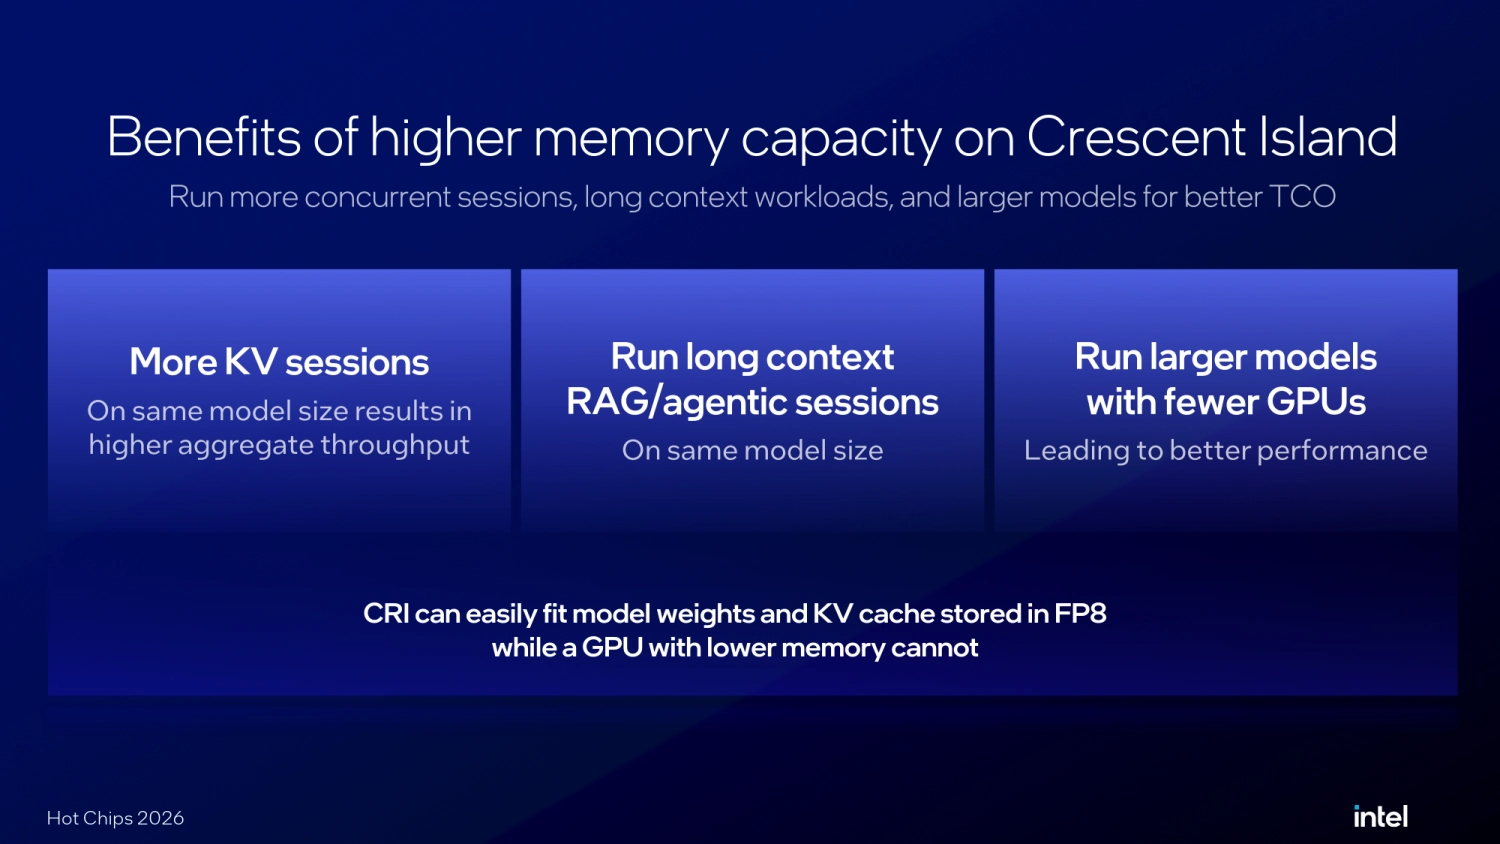
為什麼 Intel 沒有選擇 HBM,而是為 Crescent Island 配置大容量 LPDDR5X?關鍵在於,它的設計重點並不是追求最高記憶體頻寬,而是優先擴大可用容量。Agentic AI 的單一任務往往會反覆經歷 Retrieval、Reasoning、Tool Call 與 Response Generation 等多輪模型呼叫,而長 Context、RAG 與多個 Agent 並行運作,都會快速放大 Model Weights 與 KV Cache 對記憶體容量的需求。
Intel 的設計邏輯是,透過更大的本地記憶體,一張 GPU 可以同時容納更多 KV Session、支援更長的 RAG/Agent Context,並以較少 GPU 載入更大型的模型,進而改善 Tokens / Watt 與整體 TCO。依照 Intel 的說法,單張 GPU 最多可支援約 3,000 億參數模型,8 卡系統則可支援超過 1 兆參數模型。
不過,這些數字主要反映的是記憶體容量與可容納模型規模的設計定位,並不能直接等同於實際推論吞吐量、首 Token 延遲或整體回應速度已優於競爭產品。真正的效能表現,仍需視模型架構、量化格式、軟體堆疊與實際工作負載而定。
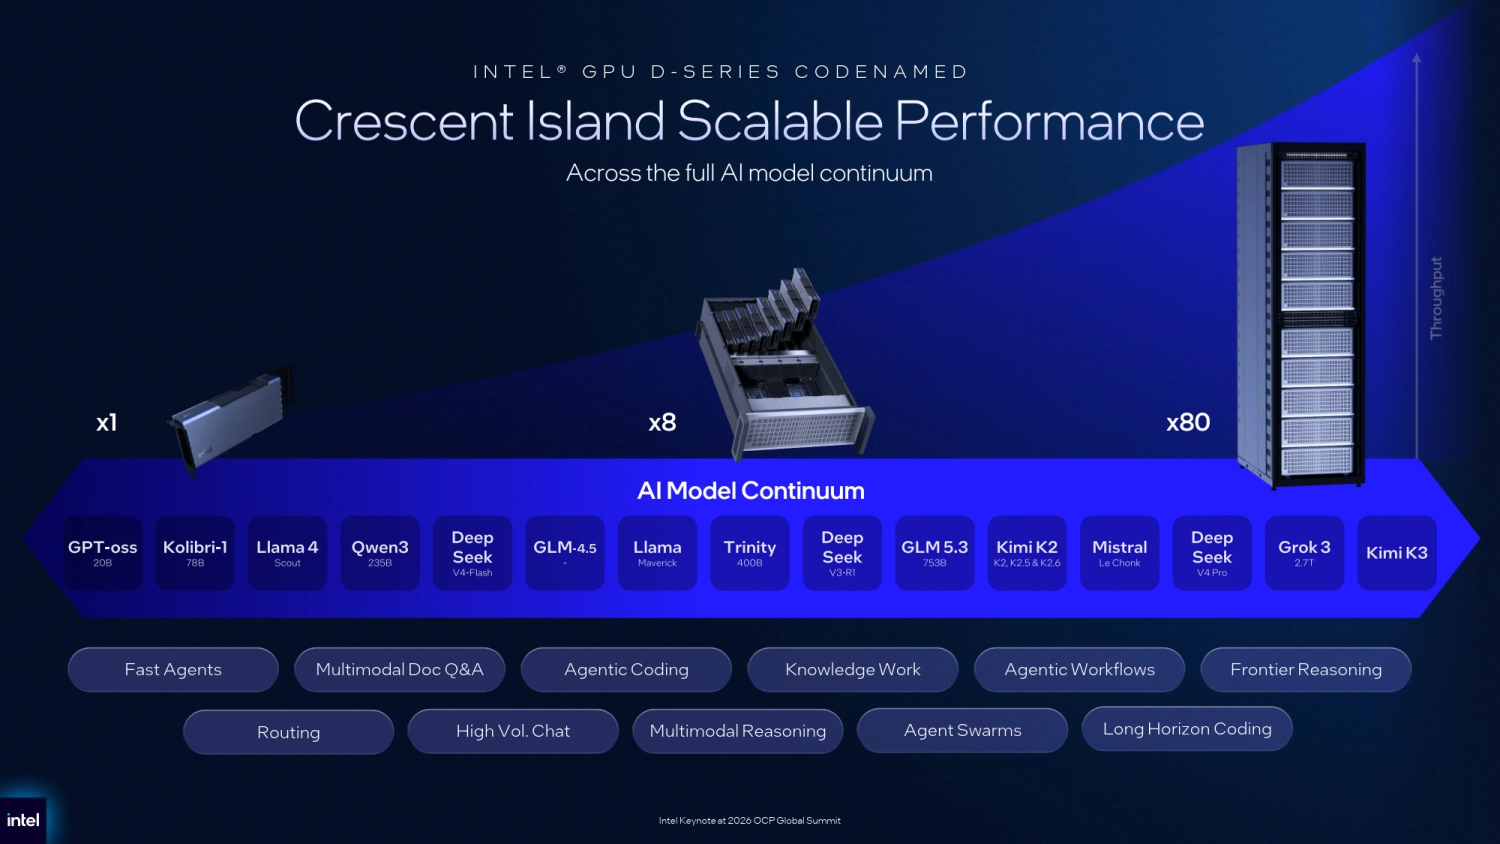
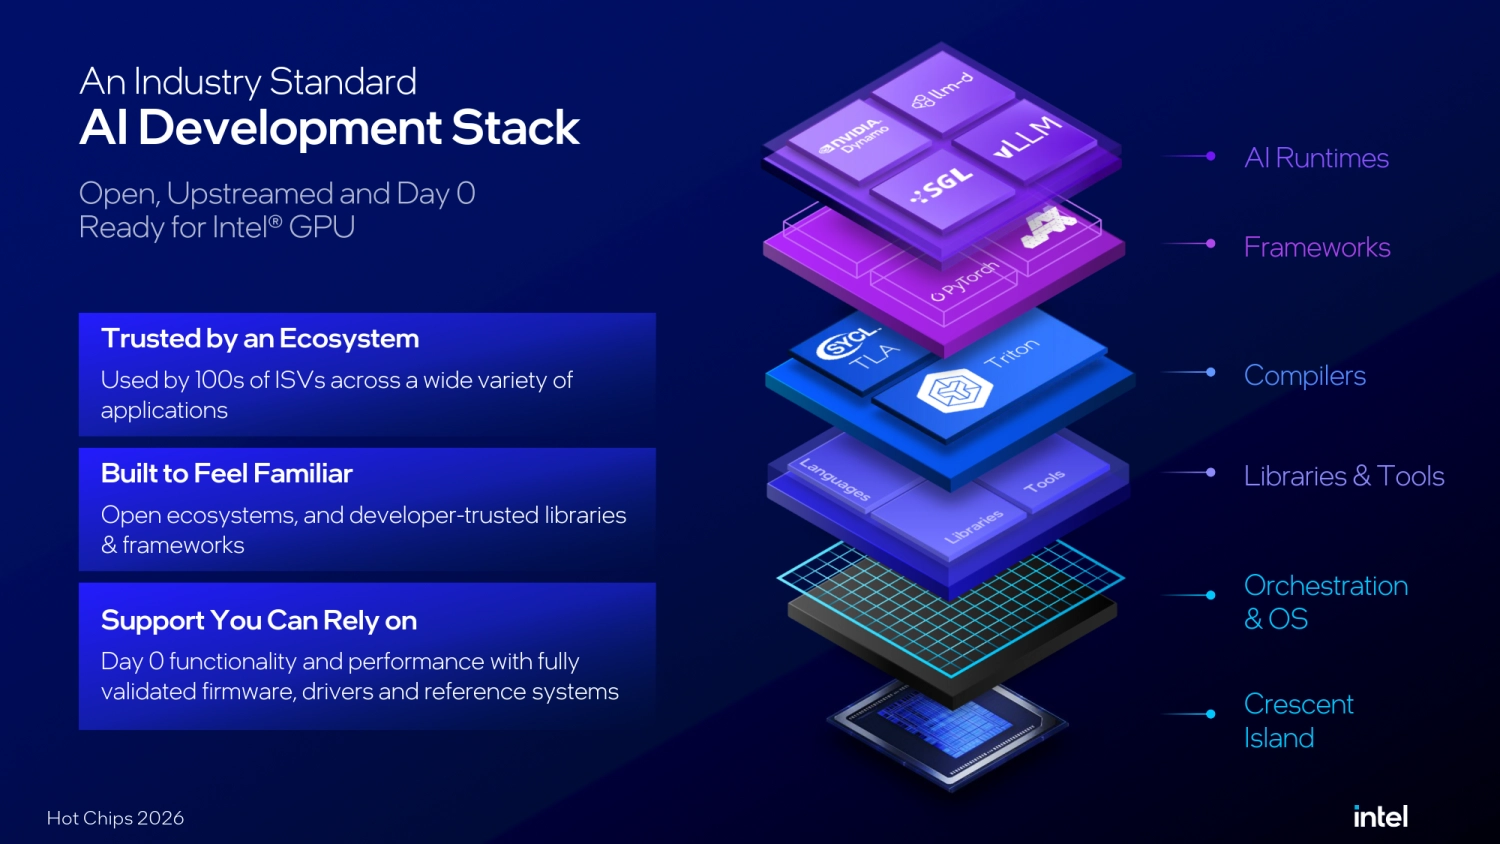
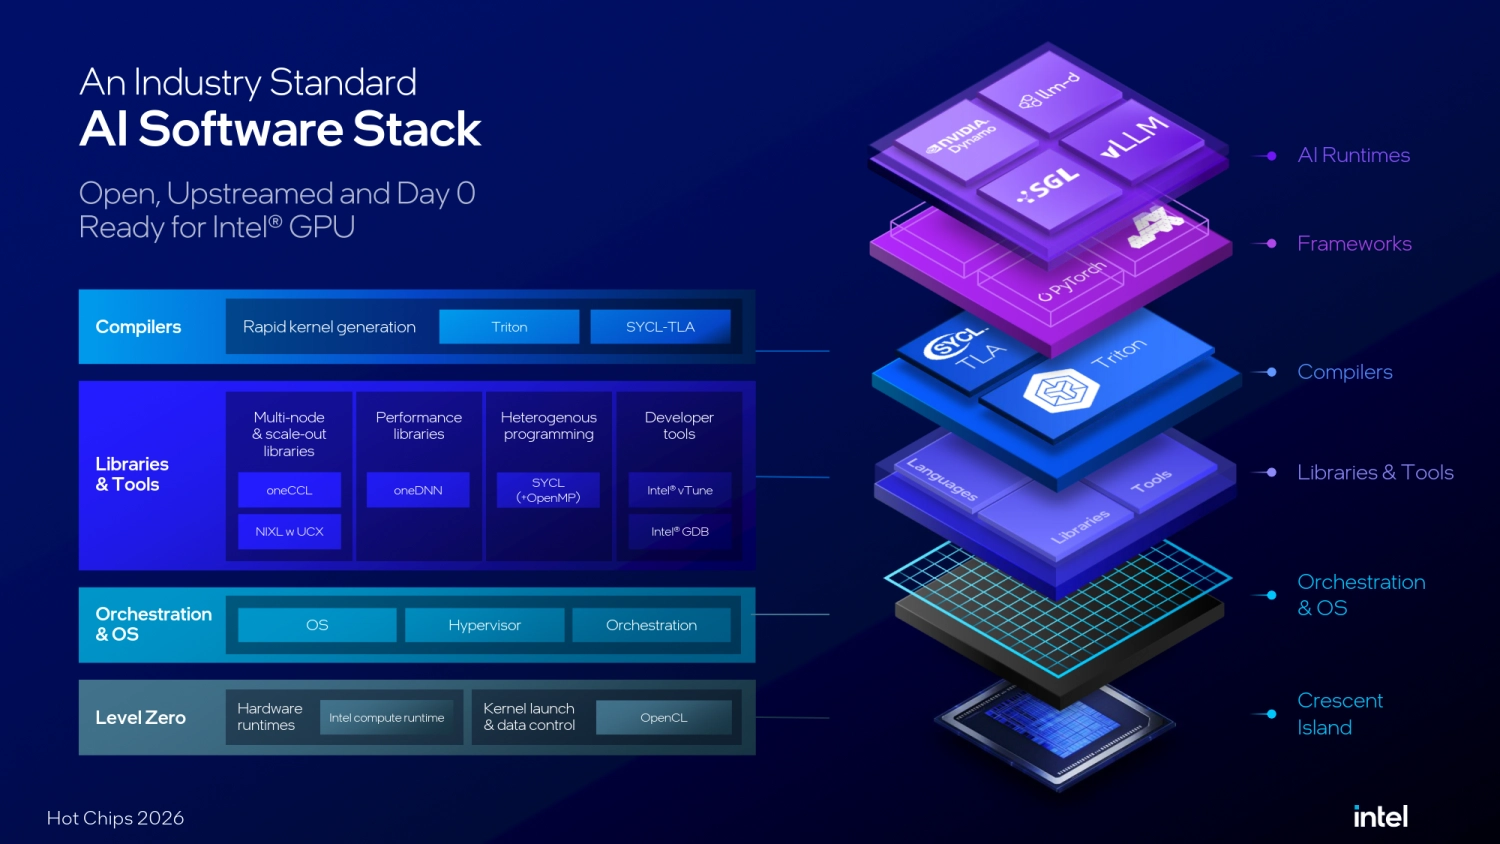
對 Intel 而言,硬體只是 GPU D-series 能否真正進入資料中心市場的一半,另一半則是軟體生態。軟體堆疊相當完整,從 Triton、SYCL-TLA、oneCCL、oneDNN、SYCL/OpenMP、NIXL with UCX,到 Intel VTune、Intel GDB、Level Zero、Intel Compute Runtime 與 OpenCL,涵蓋編譯、函式庫、通訊、除錯、執行環境與底層 Runtime。
Intel 官網則進一步強調對 vLLM 與開放式 PyTorch 生態的 Day-0 支援。這套策略的重點,是盡量避免把開發者綁定在專屬軟體堆疊中,而是透過既有的開放框架與工具,讓工作負載能在不同 Intel GPU 平台之間移植,同時讓 Xeon 與 GPU D-series 盡可能共用相同的 Framework 與 Serving Stack。
對 Intel 來說,這也是挑戰既有 GPU 生態系時最關鍵的一環。硬體規格能否轉化成實際部署優勢,最終仍取決於模型相容性、框架成熟度、效能調校與開發者體驗,因此這部分也是最需要透過實際資料中心部署來驗證的地方。
Intel 表示 Intel GPU D-series 已進入 Customer Sampling 階段,官方產品也已公開 D270 名稱與主要規格。不過,「提供客戶樣品」並不等同於已進入大規模量產或全面供貨,現階段仍應視為產品導入與驗證期。至於正式售價、完整 SKU 規劃、OEM 系統實際上市時間,以及第三方 AI Inference Benchmark 表現,目前都還有待後續公布與驗證。
Diamond Rapids:大改資料流與封裝架構
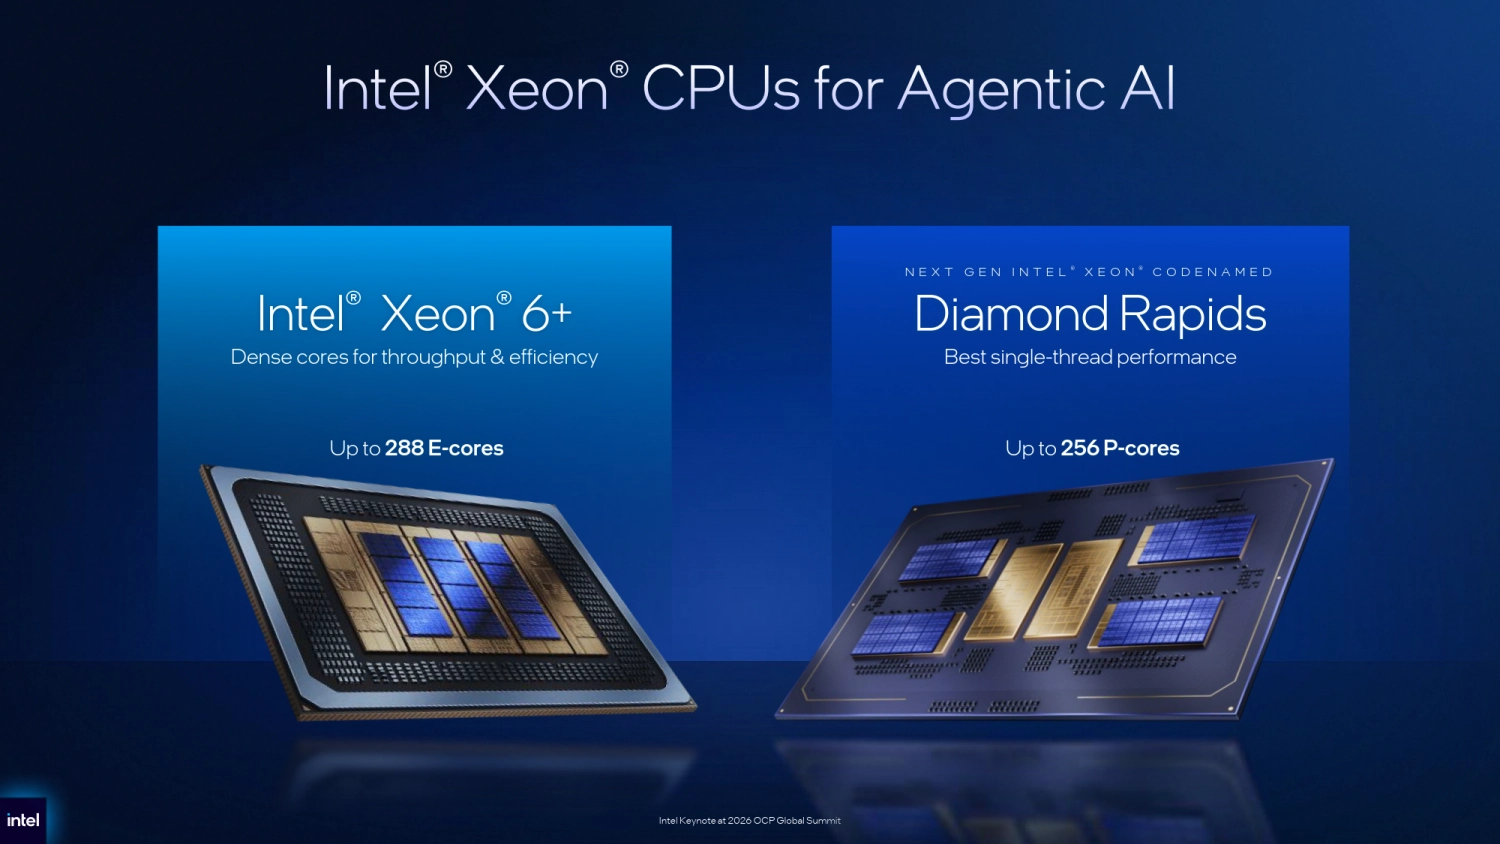
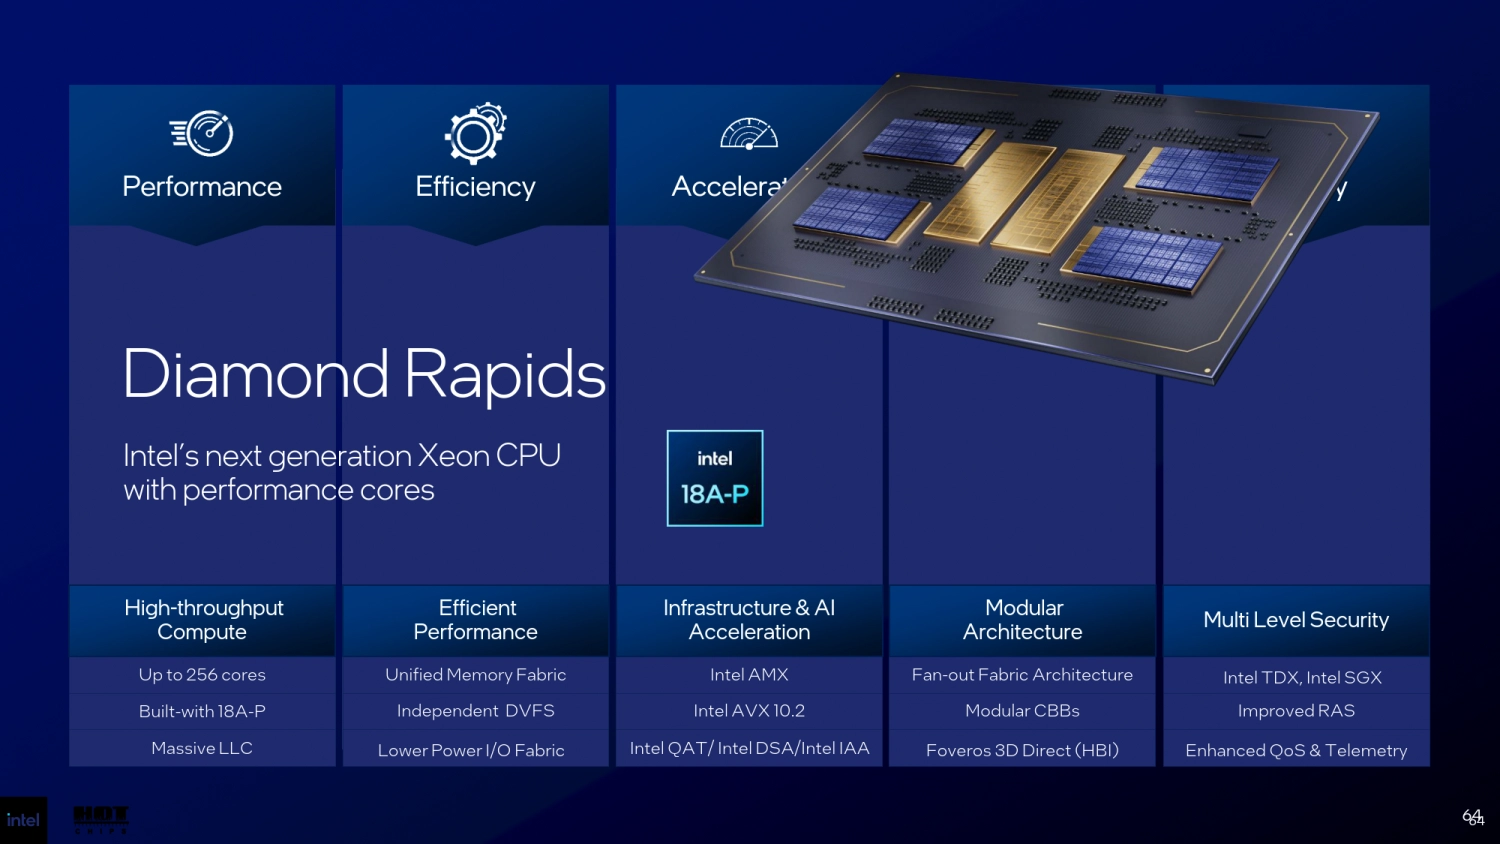
Diamond Rapids 是 Intel 下一代 Xeon P-core 產品,也是首款採用 Intel 18A-P 製程打造的 Xeon。相較於單純追求更多核心,Intel 對它的定位更偏向 Agentic AI 時代的 orchestration 與 general-purpose compute 基礎。
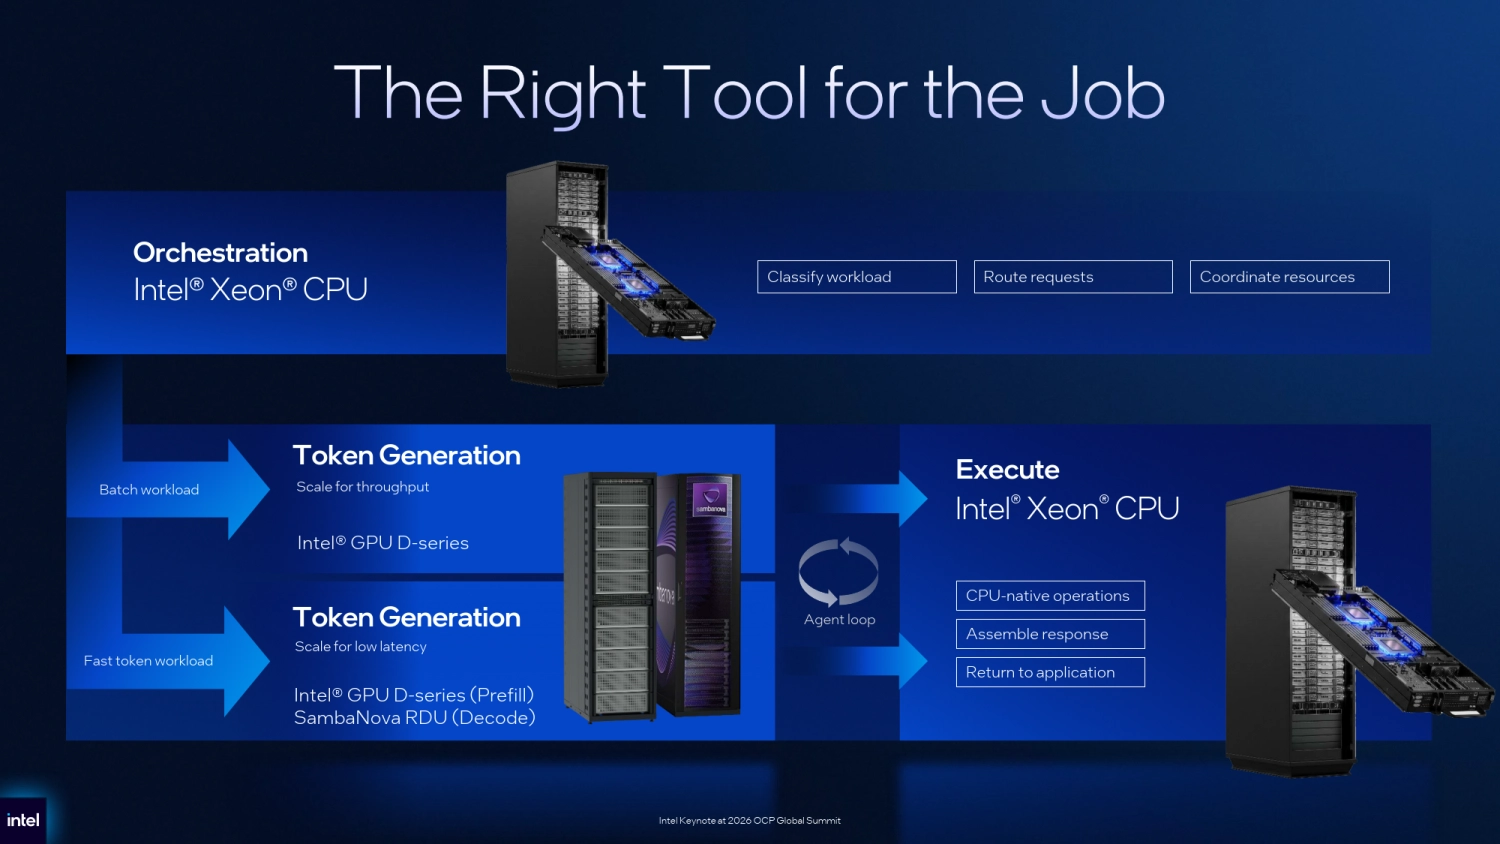
在 Intel 描繪的異質運算架構中,GPU 主要負責大規模 Token Generation,而 Xeon 則承擔 Workload Classification、Request Routing、Resource Coordination、CPU-native Tool Execution、Response Assembly,以及資料搬移等工作。換句話說,Xeon 並不是要和 GPU 爭奪同一類 AI 運算,而是負責協調整個 Agentic AI 工作流程。
這也解釋了為什麼 Diamond Rapids 的設計重點不只放在核心數量,而是同步強化 Memory Fabric、I/O、Cache Coherence 與整體資料流效率。對 Agentic AI 而言,真正的瓶頸往往不只是算力本身,而是不同運算單元之間如何快速交換、協調與存取資料。
Diamond Rapids 最大的架構變化之一,就是導入全新的 Fan-out Fabric。回顧 Xeon 過去的演進,Intel 從 Ring、Mesh、Tiled Mesh 一路走向 Modular Mesh,而到了 Diamond Rapids,運算核心與 I/O、Memory 的功能分工變得更徹底。
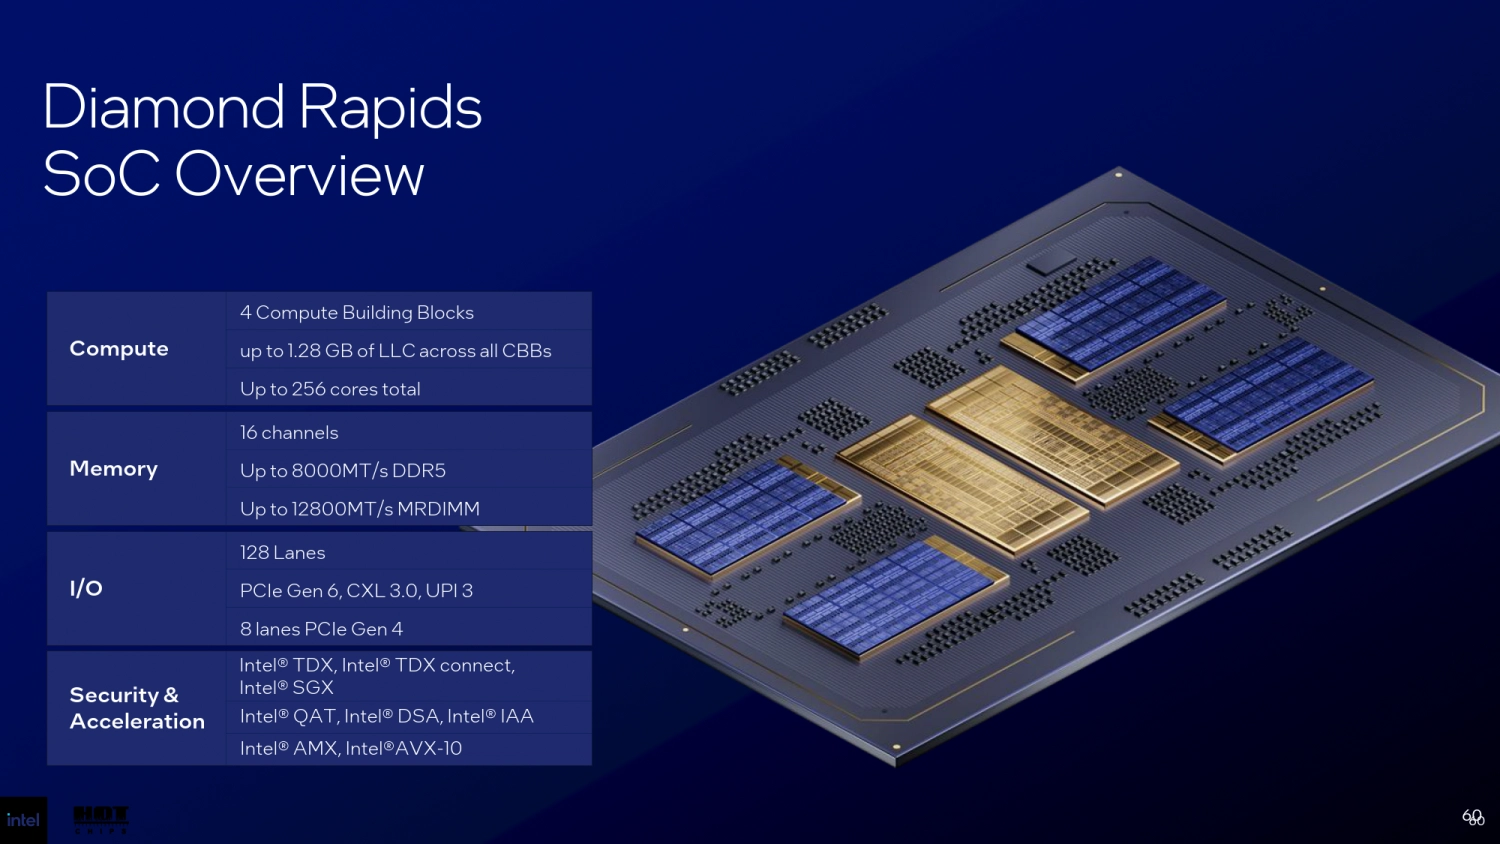
在新的設計中,四組 Compute Building Block 主要負責 Cores、L2 Cache 與 Shared LLC,中央的 Fabric Hub 則集中處理 DDR、I/O 與 Accelerator,並透過 Unified Memory Fabric 與 Flexible I/O Fabric 串接整個處理器。這種更明確的 Function-based Partitioning,讓不同功能區塊不必再被固定綁在同一顆大型 Die 上。
這套架構的價值,在於未來 Intel 可以更彈性地調整 Compute Building Block 與 Fabric Hub 的配置比例,依照核心數、記憶體頻寬或 I/O 需求擴充不同產品,而不必讓 CPU 核心、記憶體控制器與 I/O 全部隨著單一大型 Die 一起放大。對高核心數、重 I/O 與高記憶體頻寬的資料中心處理器而言,這也為後續產品擴充留下更大的架構彈性。
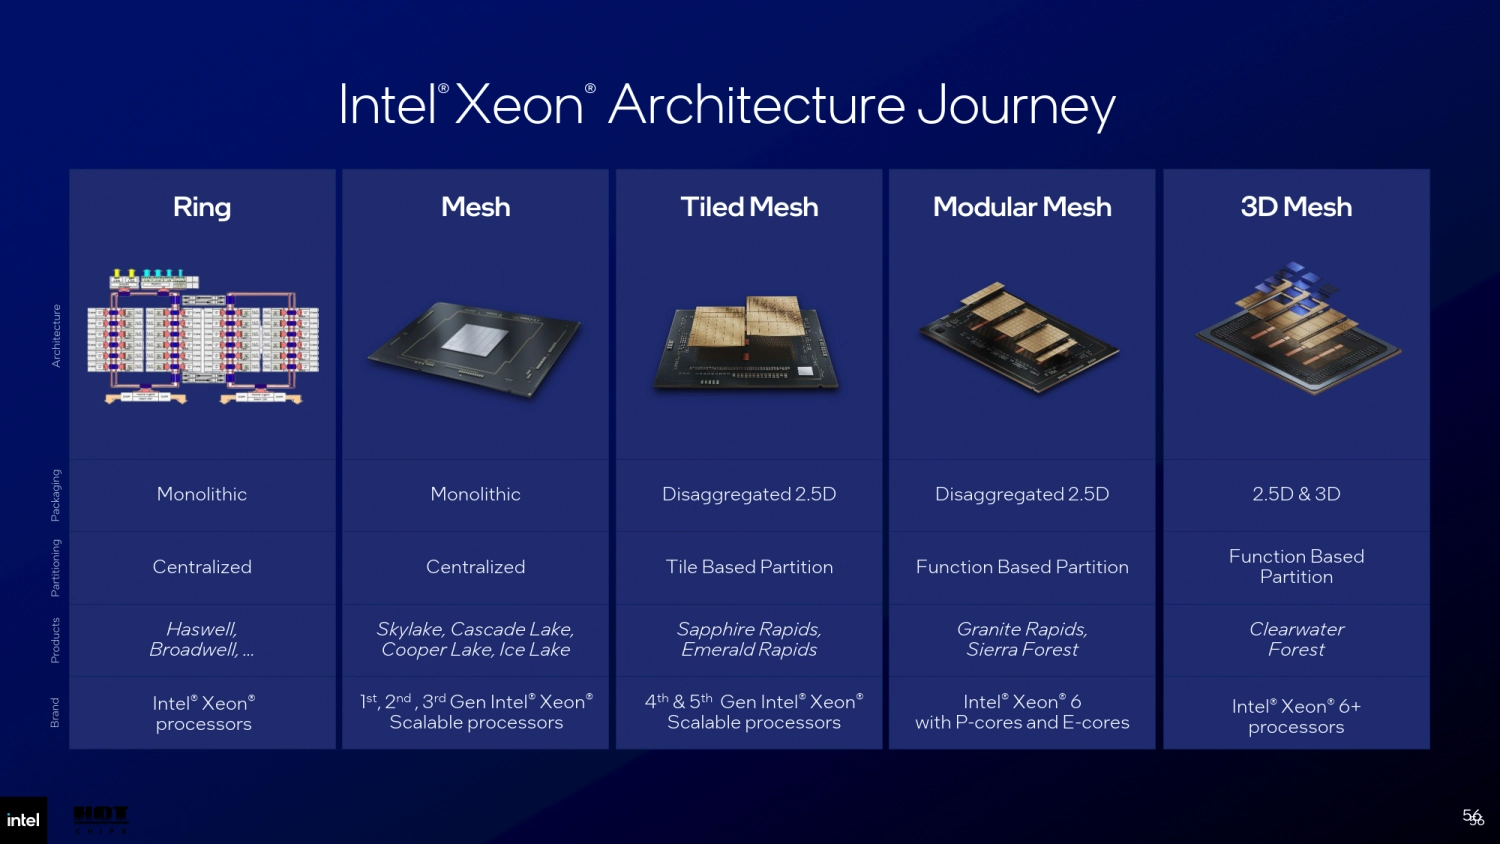
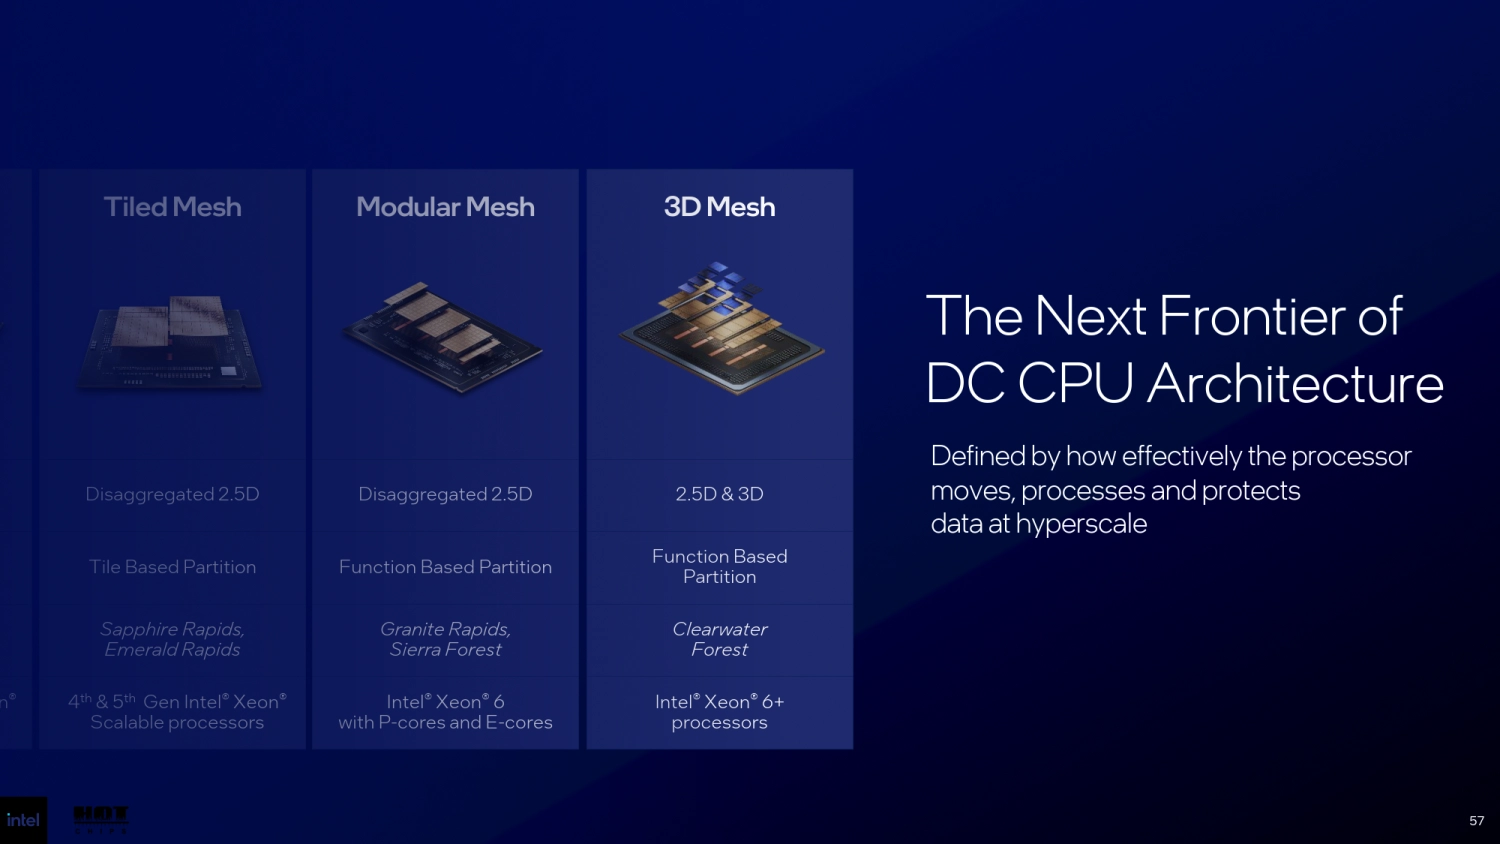
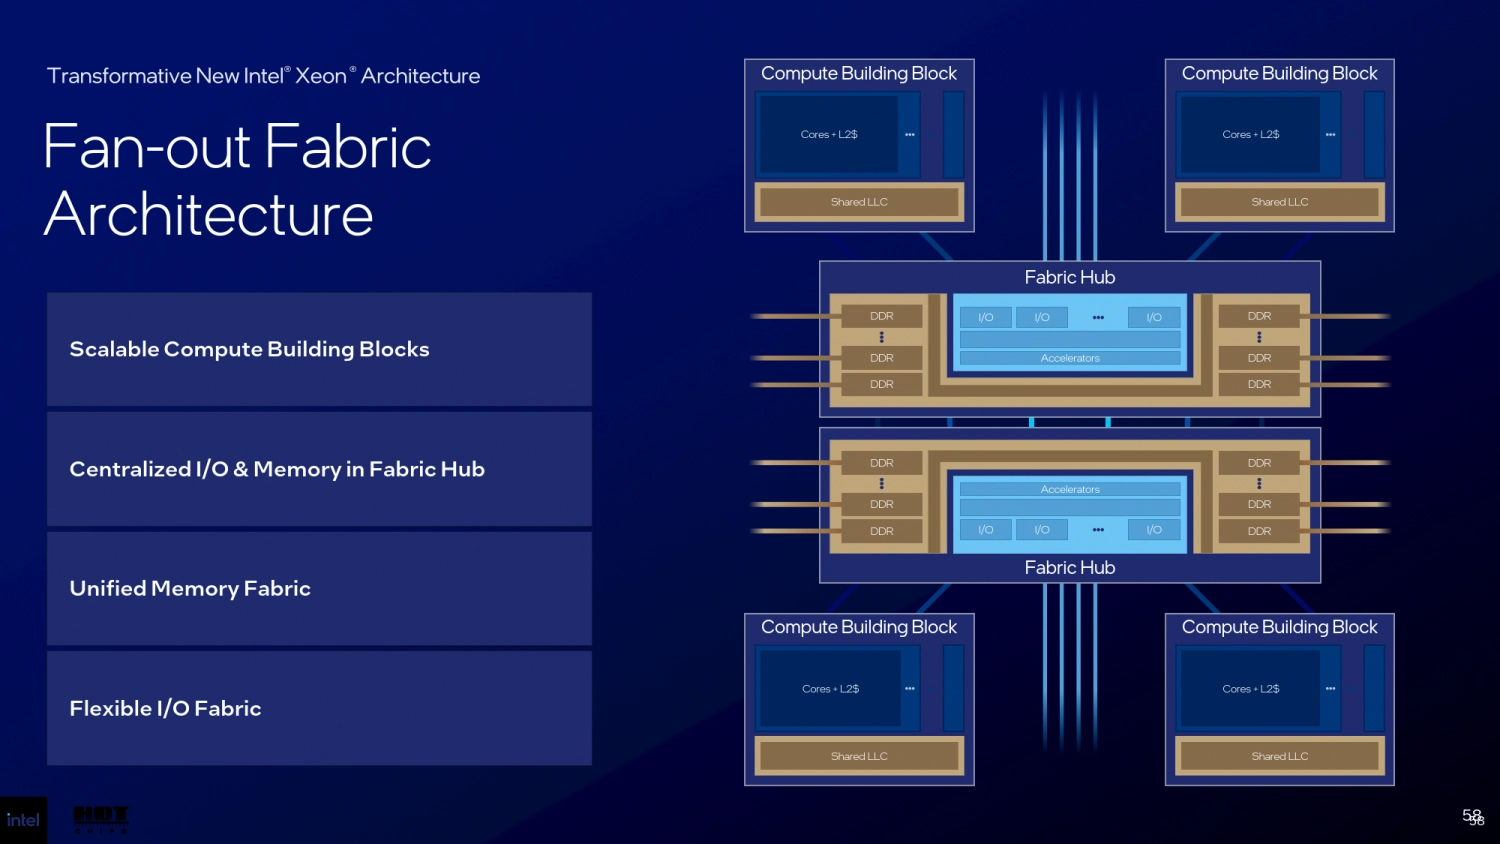
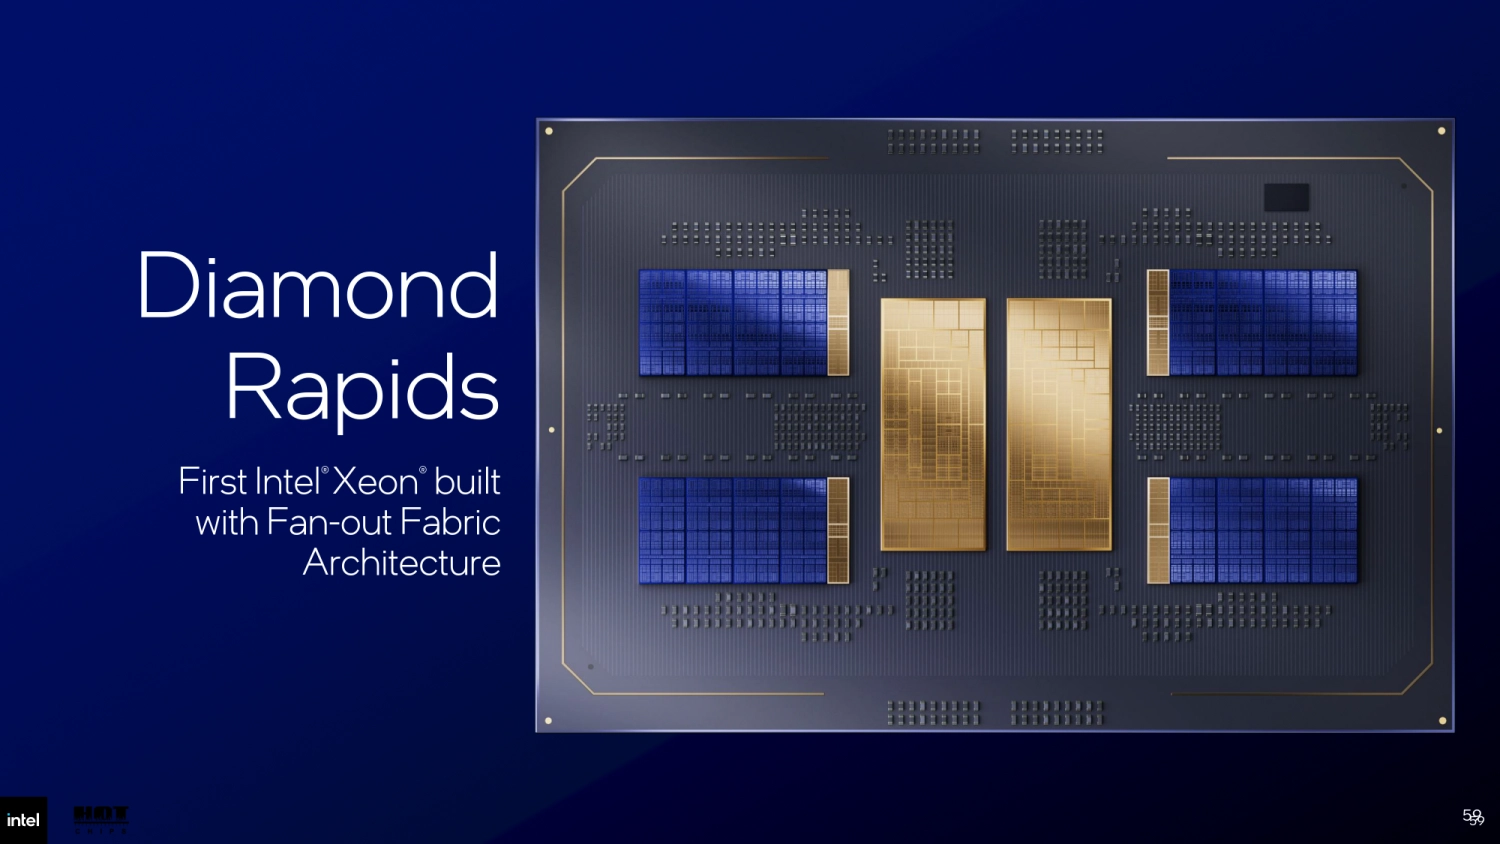
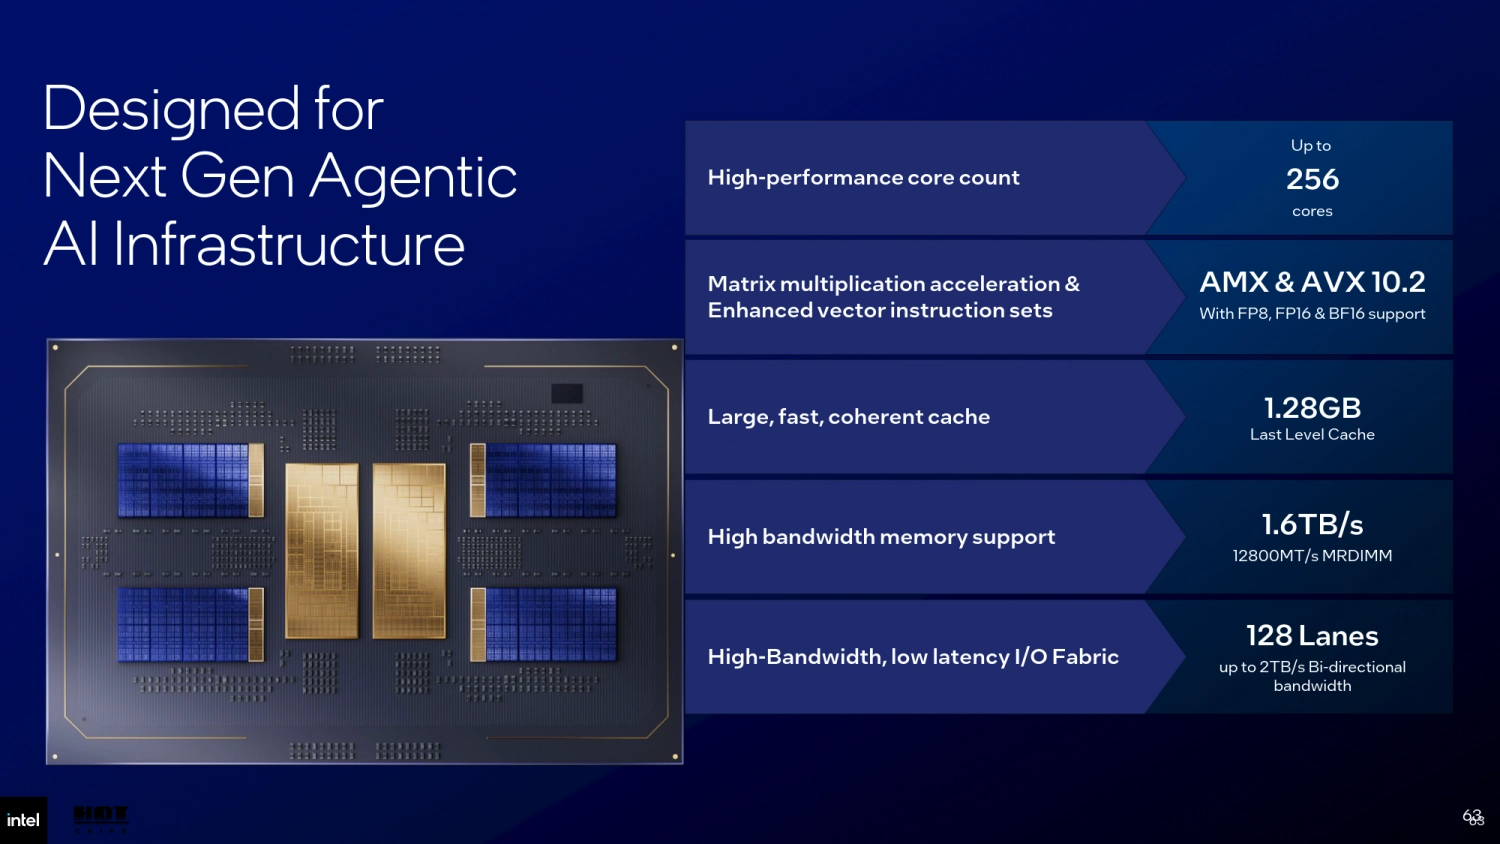
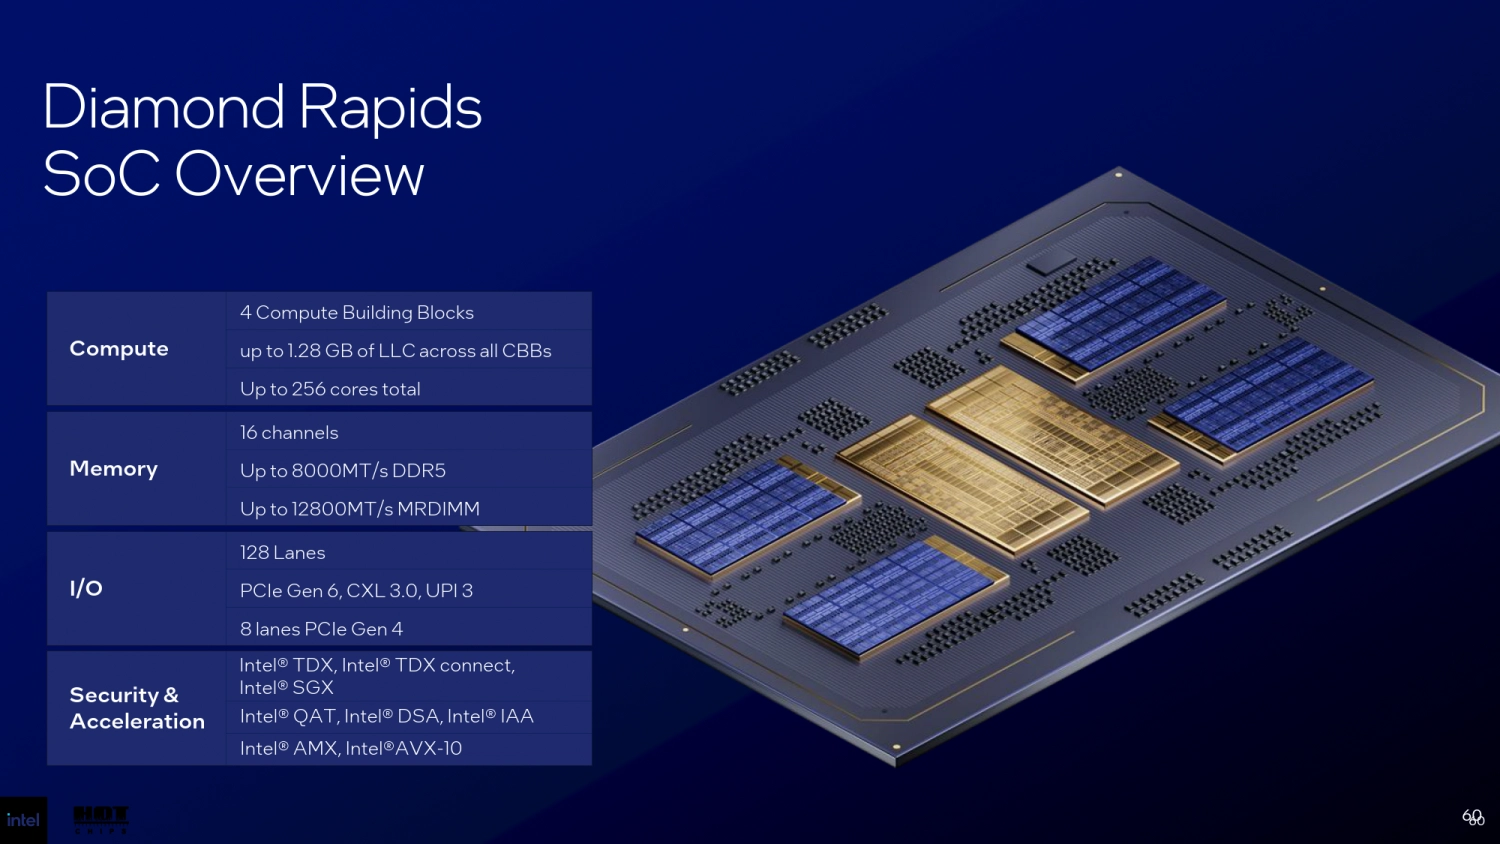
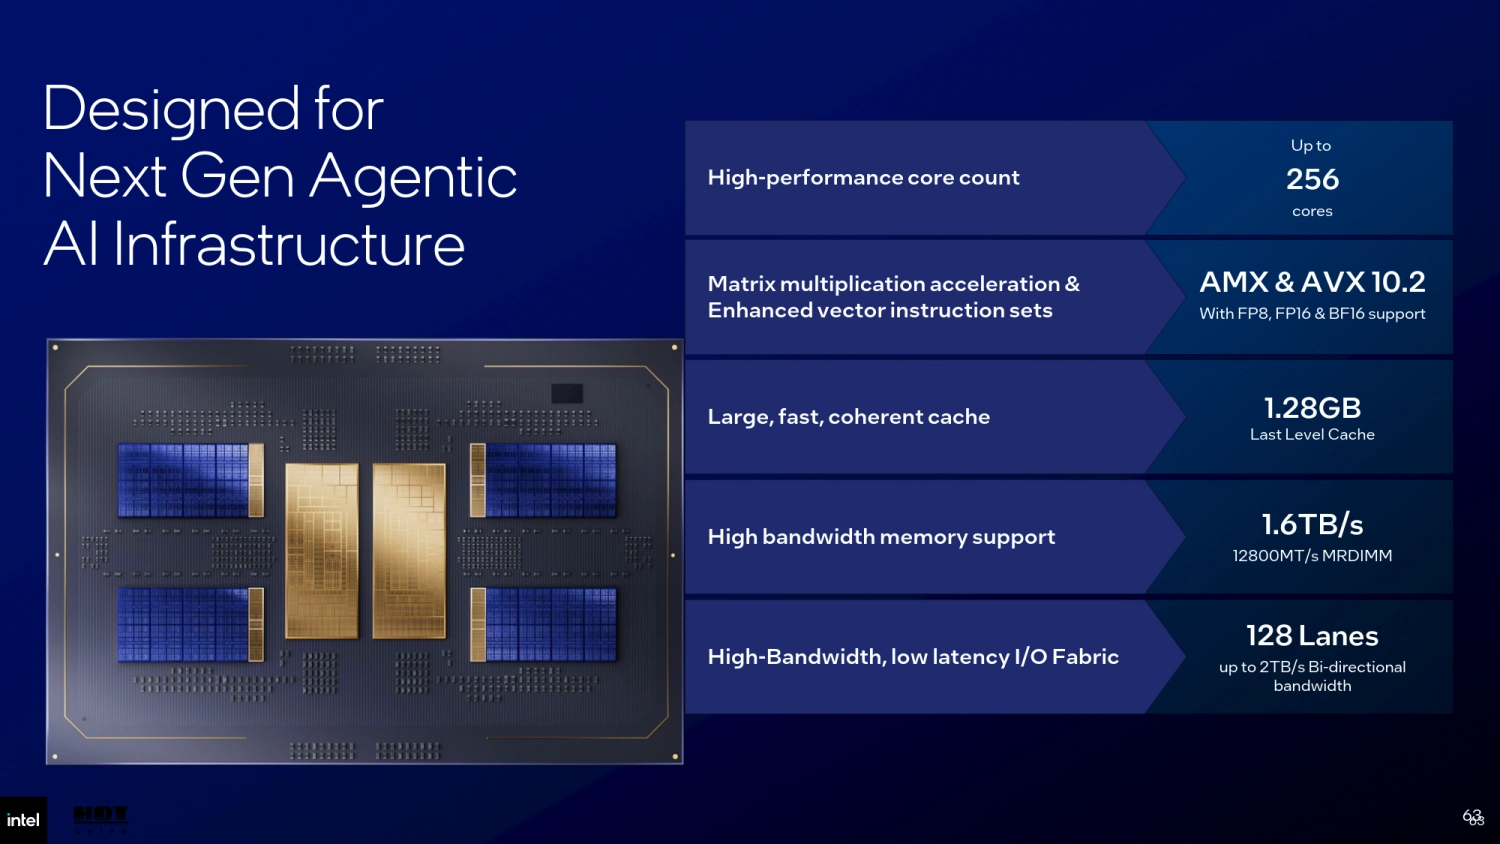
規格方面,Intel 目前公布 Diamond Rapids 最高配置 256 個 P-core,並由四組 Compute Building Block 組成,總計最高提供 1.28GB LLC。記憶體部分具備 16 個通道,支援 DDR5-8000,MRDIMM 則可達 12800MT/s,最高記憶體頻寬約為 1.6TB/s。
I/O 方面,Diamond Rapids 提供 128 條 PCIe Gen6/CXL 3.0/UPI 3 通道,另外還有 8 條 PCIe Gen4。這 128 條高速 I/O 通道的雙向總頻寬最高可達約 2TB/s。
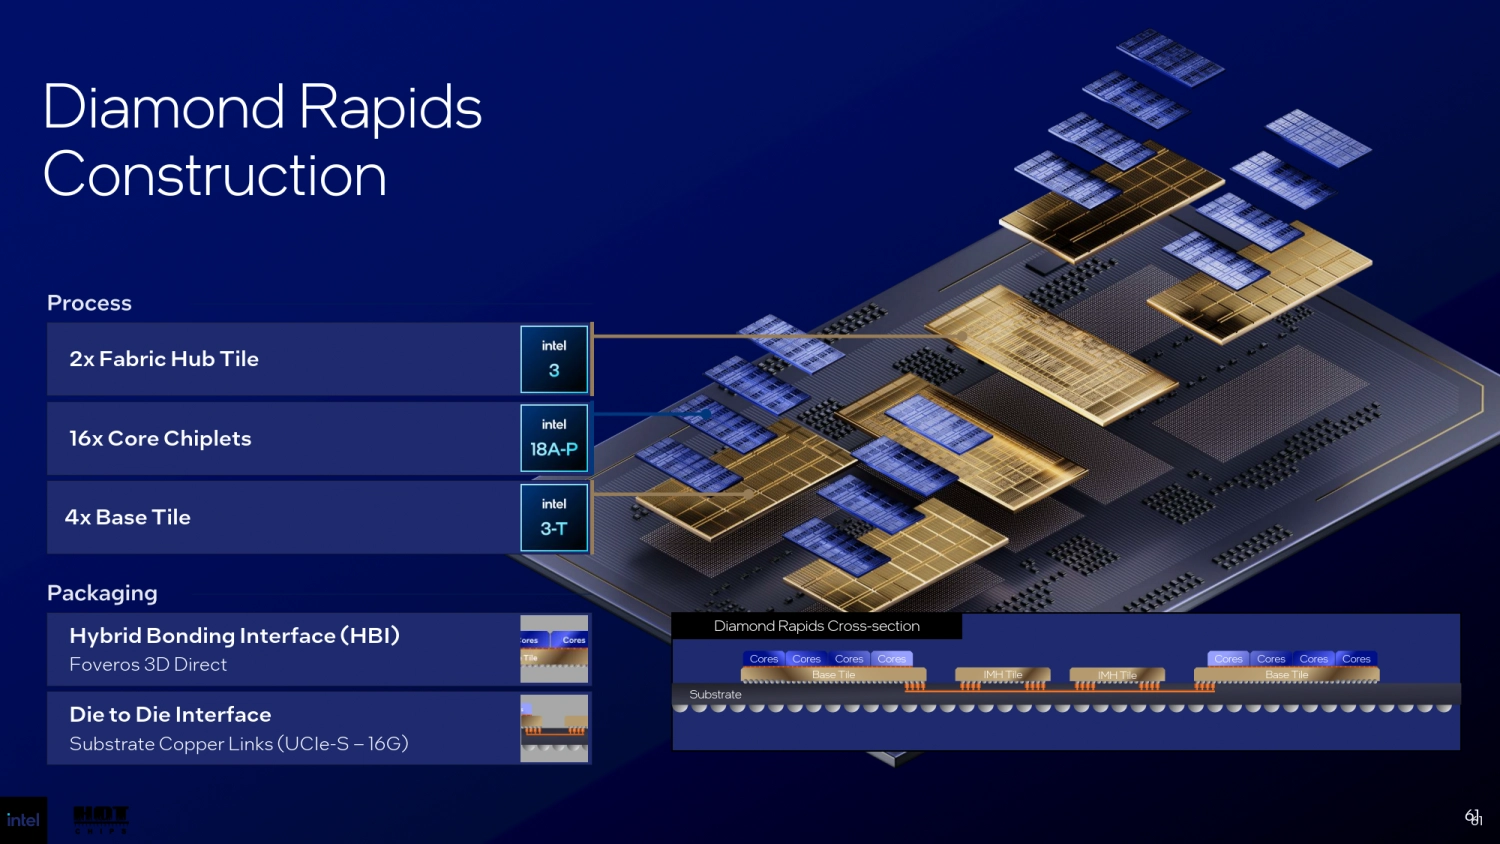
Diamond Rapids 的封裝設計,更能看出 Intel 對 Chiplet 與 3D Integration 的投入。完整 SoC 由 2 個 Fabric Hub Tile、16 個 Core Chiplet,以及 4 個 Base Tile 組成;其中 Core Chiplet 採用 Intel 18A-P 製程,Fabric Hub Tile 與 Base Tile 則使用 Intel 3-T 製造。
在垂直堆疊部分,Core Chiplet 與 Base Tile 之間透過 Hybrid Bonding Interface(HBI)與 Foveros 3D Direct 連接;而位於 Substrate 上的 Die-to-Die 互連,則採用 UCIe-S 16G。也就是說,Diamond Rapids 並非傳統單一大型 CPU Die,而是同時結合 2.5D 與 3D 封裝技術,將運算核心、Fabric 與基礎邏輯拆分到不同晶片層級,再透過先進封裝整合成完整處理器。
這種設計不只提高模組化彈性,也讓不同功能區塊可以各自選擇更合適的製程與晶片配置,進一步強化高核心數 Xeon 在效能、擴充性與製造效率上的設計空間。
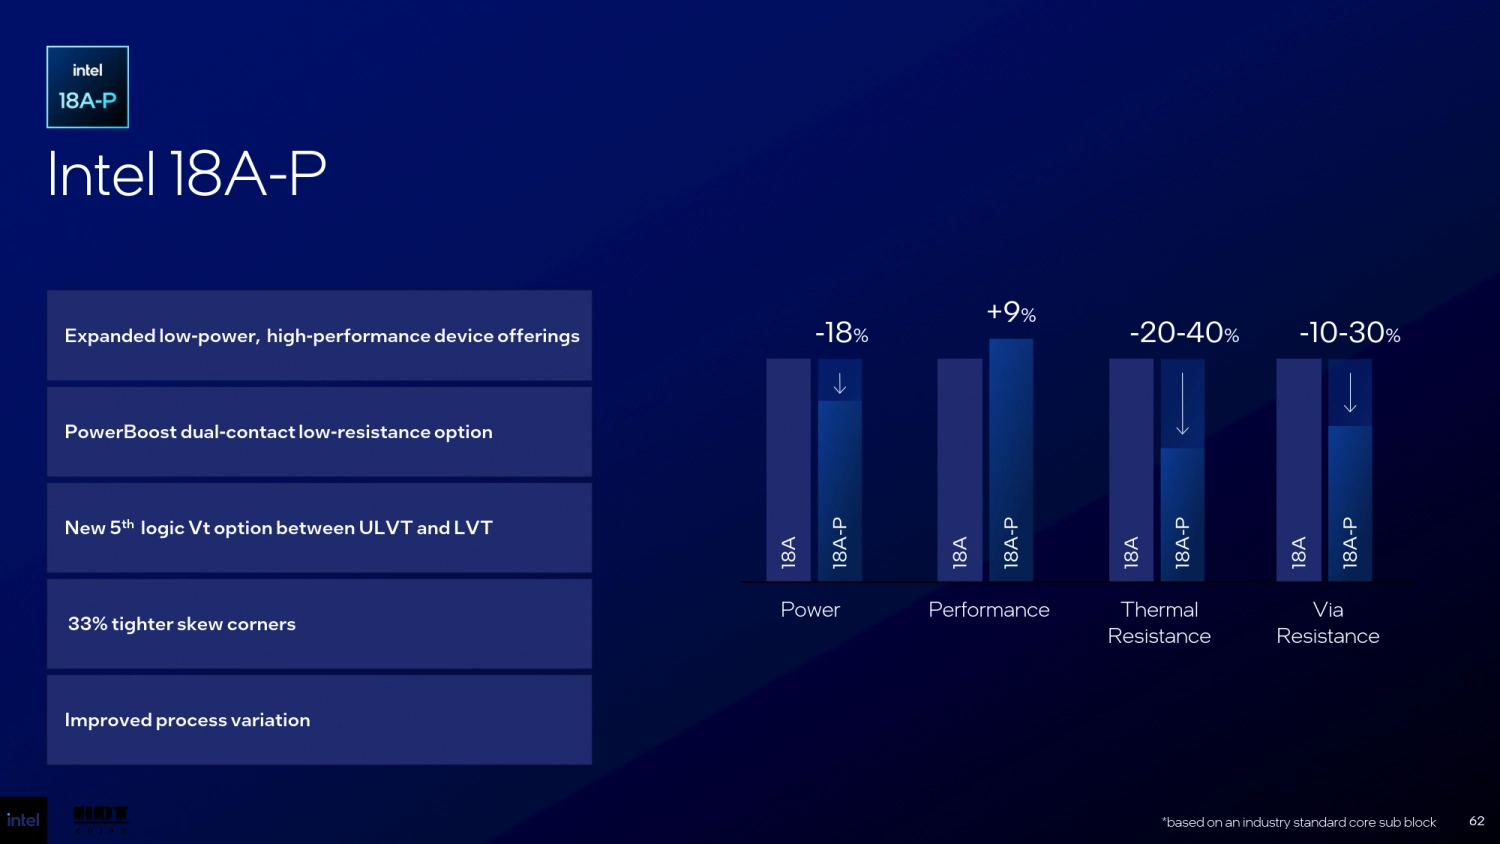
18A-P 並不是單純將 18A 進一步微縮,而是針對效能、功耗與製程特性做進一步強化。依照 Intel Foundry 公布的資料,相較 18A,18A-P 在相同功耗條件下最高可帶來約 9% 的效能提升,或在維持相同性能時降低約 18% 的功耗。
Intel 也在 18A-P 中導入 PowerBoost dual-contact transistor、第五種 logic Vt,以及 33% tighter skew corner,並宣稱可改善約 20~40% 的 thermal resistance,以及 10~30% 的 via resistance。這些調整顯示 18A-P 的重點,不只是邏輯電晶體本身,也包含供電、熱傳與互連等製程層級最佳化。
不過需要注意的是,Intel 明確指出這些數據是基於 industry-standard core sub-block 測得,因此應視為 18A-P 製程本身的特性指標,不能直接解讀為 Diamond Rapids 整顆 CPU 一定能獲得 9% 效能提升或 18% 功耗下降。實際產品表現仍會受到核心架構、時脈、功耗設定、封裝與系統配置等因素影響。
在 AI 與資料中心加速能力方面,Diamond Rapids 將 AMX 與 AVX 10.2 納入核心運算能力,支援 FP8、FP16 與 BF16 等資料格式;此外,平台也整合 QAT、DSA、IAA 等資料中心加速器,以及 TDX、TDX Connect、SGX 等安全功能。
這樣的配置也進一步說明 Diamond Rapids 在 AI 基礎架構中的定位:它並不是要取代 GPU,而是負責處理 Agent Loop 中更適合 CPU 執行的工作,包括 CPU-native inference、資料前後處理、加密、壓縮、資料搬移,以及 Orchestrator 協調等任務。換句話說,GPU 主要承擔高吞吐量的模型運算,而 Xeon 則負責把周邊資料處理、系統協調與安全機制串接起來,形成完整的 Agentic AI 工作流程。
不是三條獨立產品線 而是 Agentic AI 分工
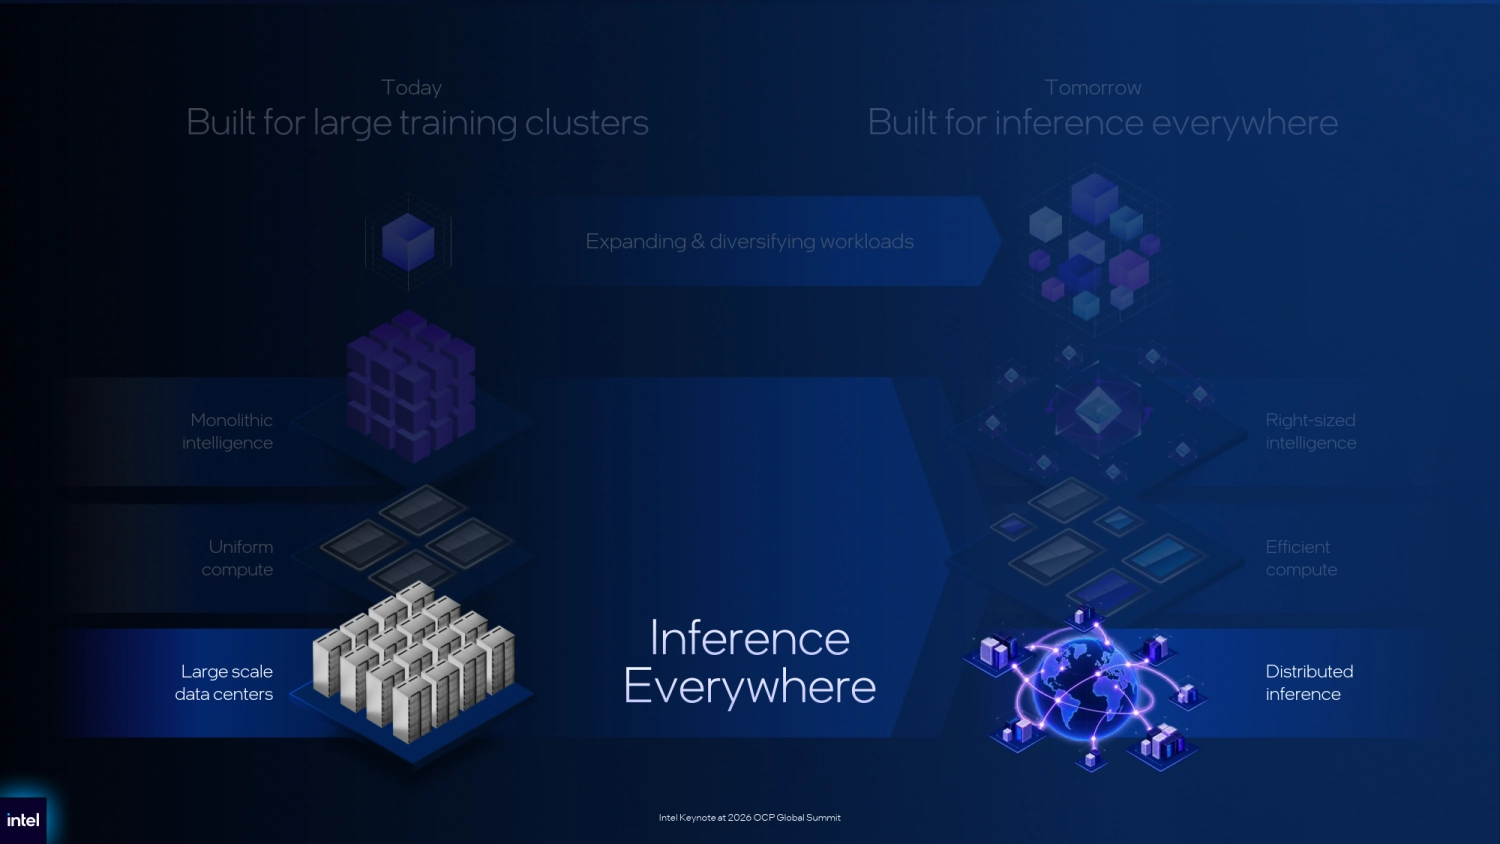
Intel 對 Agentic AI 的判斷是,未來 AI 基礎架構將從今日以大型 Training Cluster 為核心的集中式運算模式,逐步走向「Inference Everywhere」,而模型部署也會從單一、龐大的集中式 Intelligence,轉向更貼近實際工作負載需求的 Right-sized Intelligence。
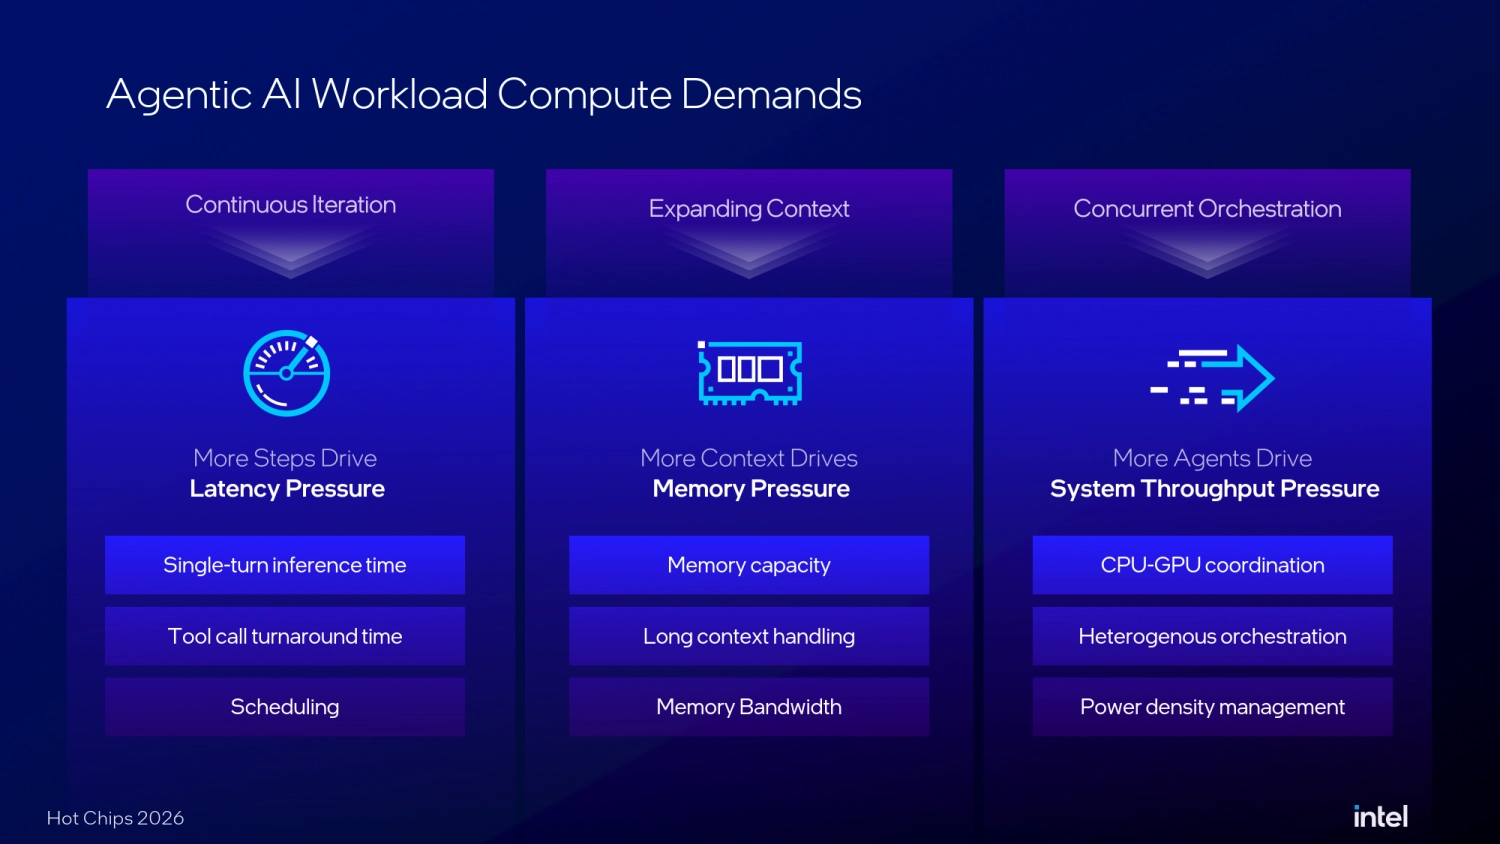
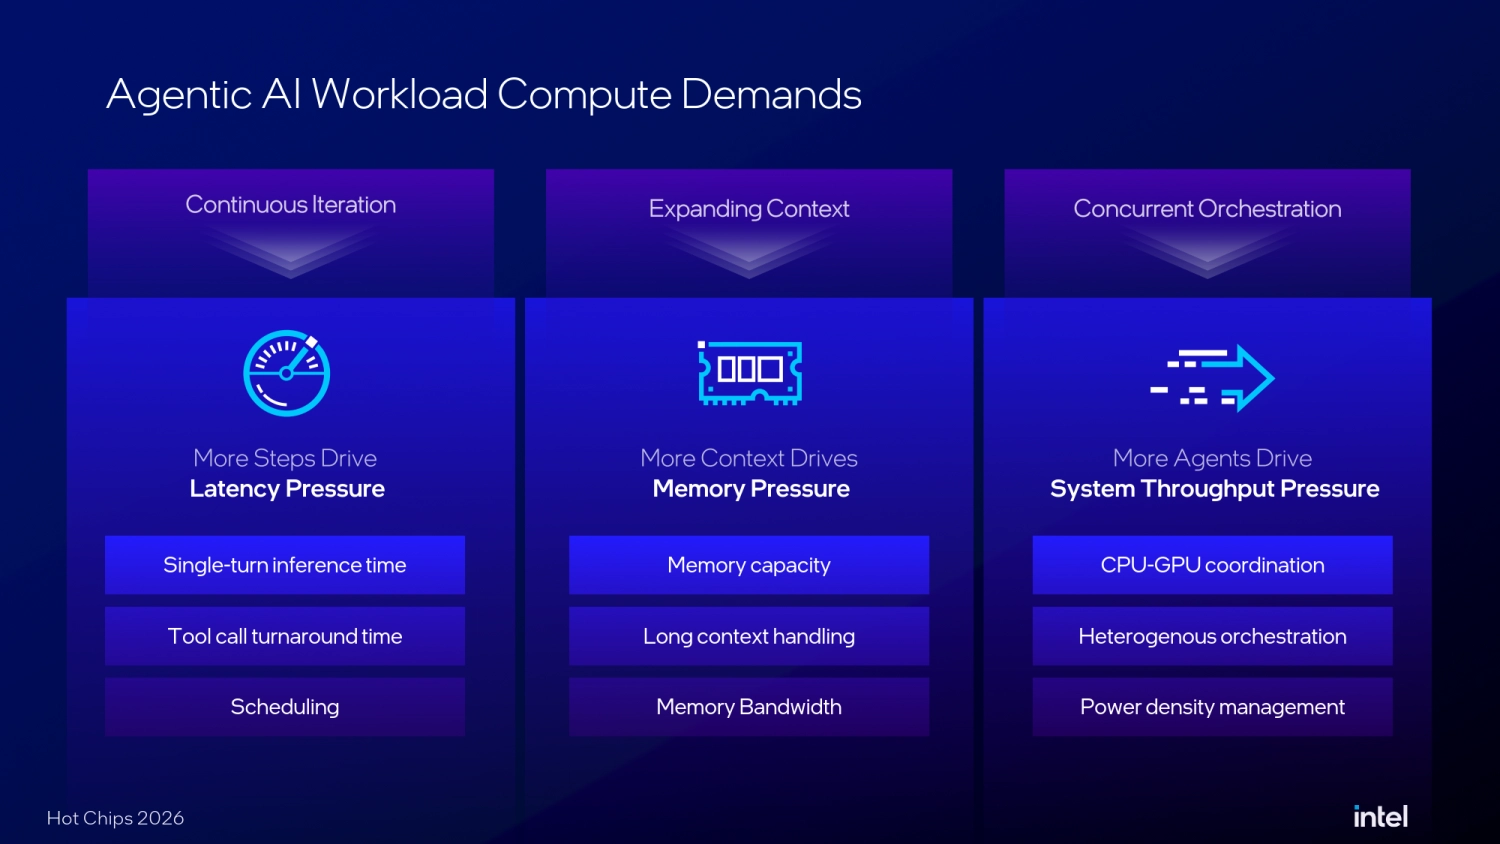
這種轉變也帶來三類壓力同時上升:多步驟、反覆迭代的 Agent Workflow 會增加 Latency Pressure;更長的 Context 與持續累積的工作狀態會放大 Memory Pressure;而多個 Agent 並行執行,則進一步推高 System Throughput 與 Heterogeneous Orchestration 的負擔。
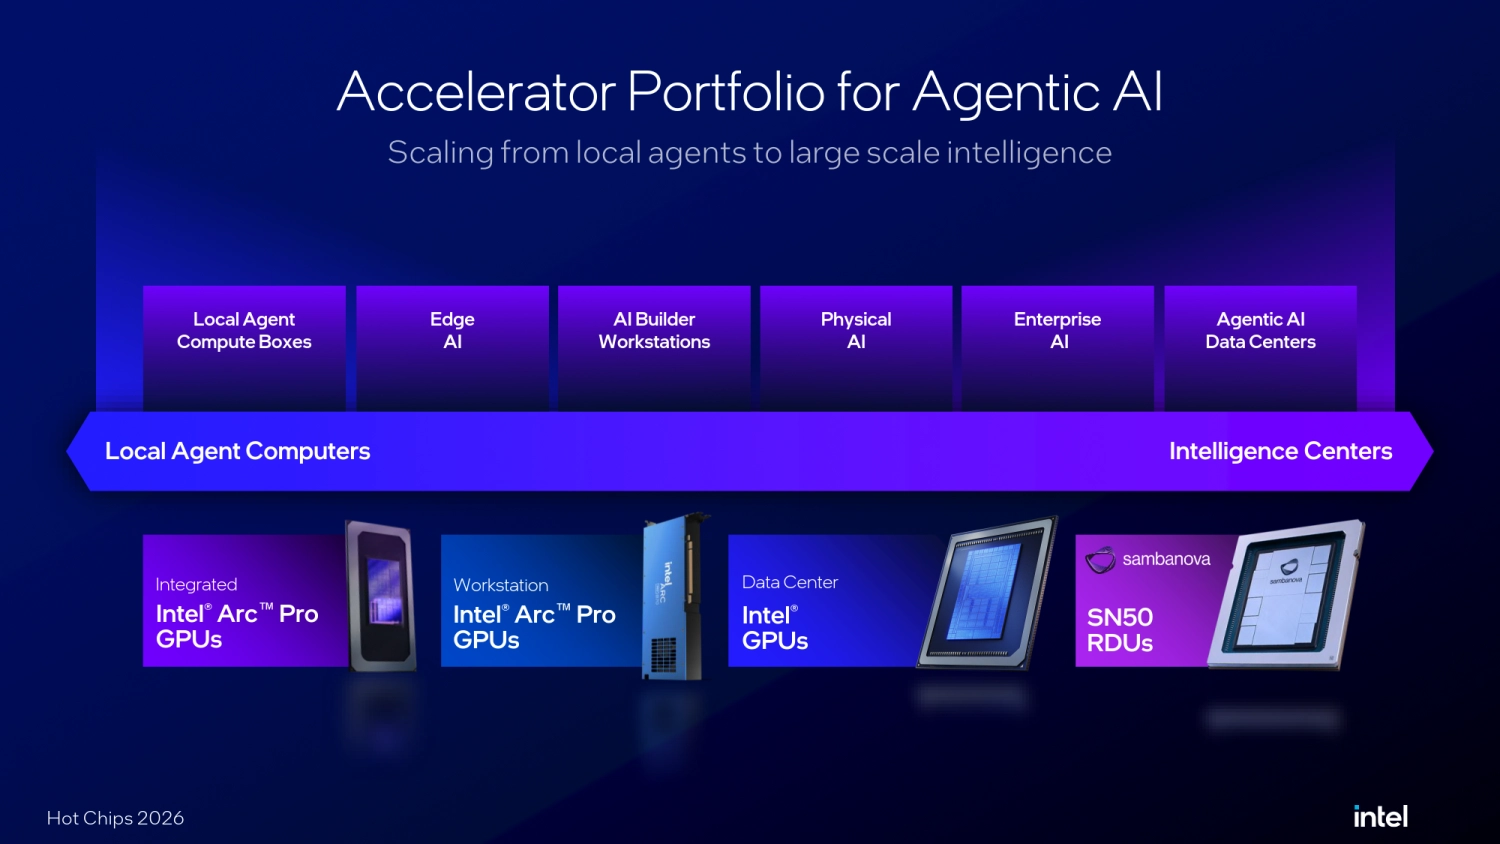
也正因如此,Intel 才將 Wildcat Lake、Crescent Island 與 Diamond Rapids 分別放在不同運算位置:前者負責終端與邊緣側的本地 AI,Crescent Island 著重大容量、高效率的模型推論,而 Diamond Rapids 則承擔資料中心中的協調、通用運算與系統編排工作。三者並非彼此取代,而是共同構成 Intel 對 Agentic AI 時代異質運算架構的完整分工。
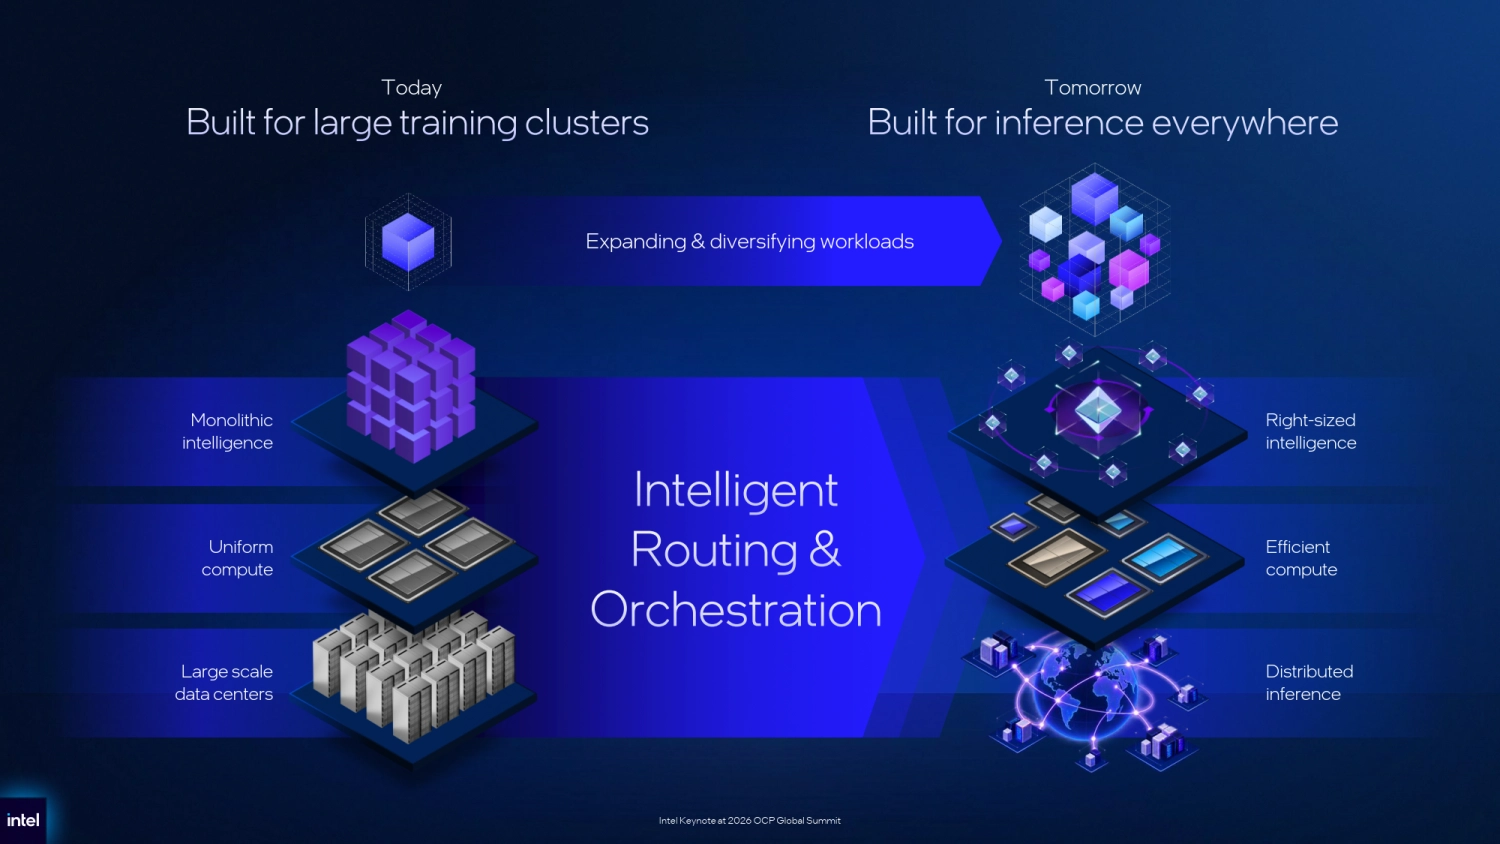
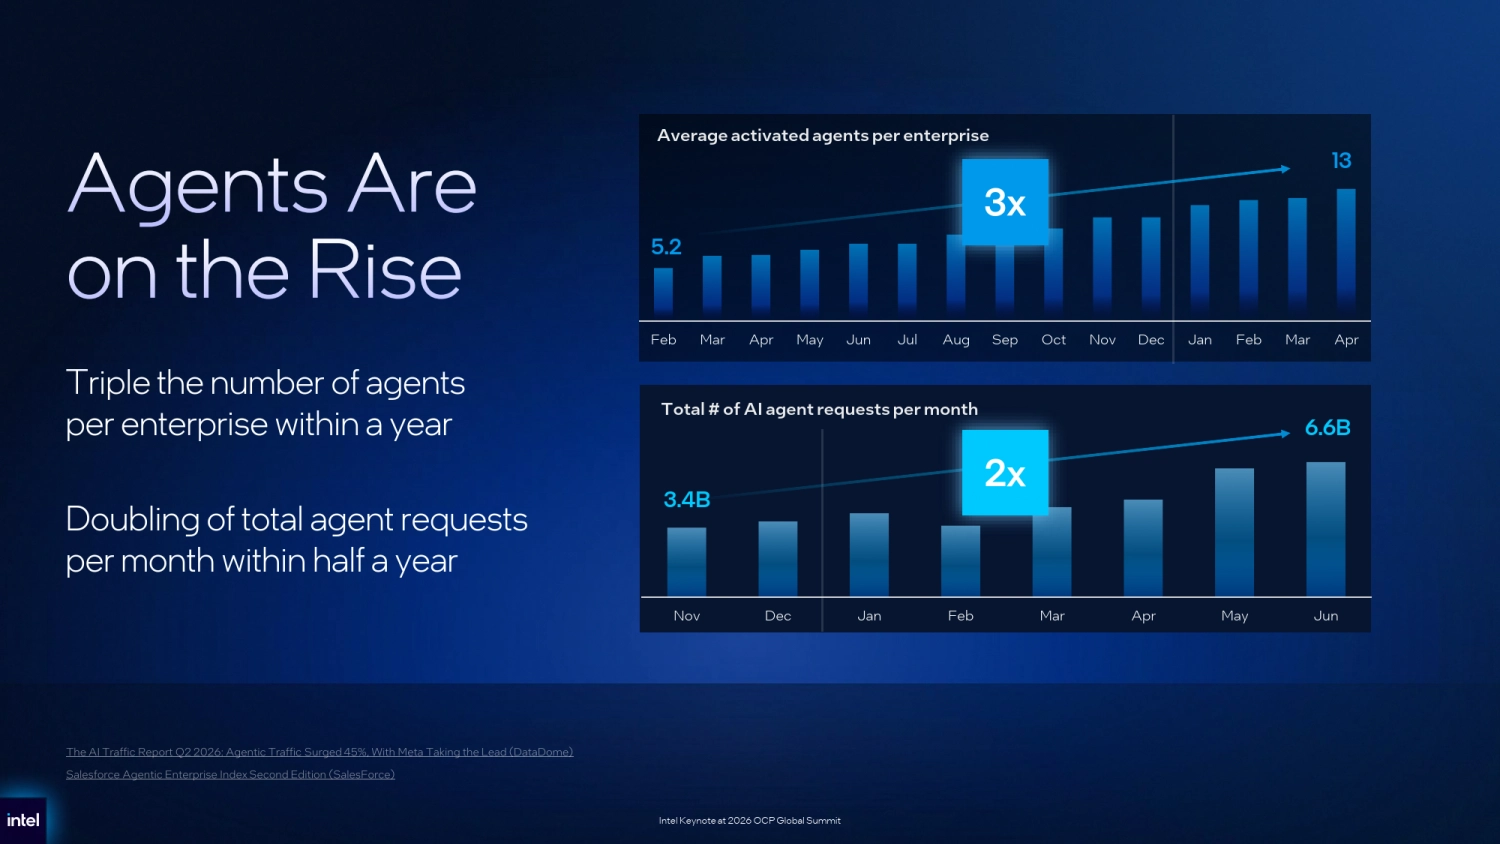
從系統層來看,Intel 對三類產品的分工其實相當明確:Wildcat Lake 的角色,是盡量把適合在終端完成的 AI 工作留在端點執行;Crescent Island 則透過大容量記憶體,降低長 Context 與大量 KV Cache 對多張 GPU 的依賴;Diamond Rapids 的任務,則是避免讓昂貴的加速器把資源耗在 CPU 更擅長的 Orchestration、I/O 與 Tool Call 等工作上。
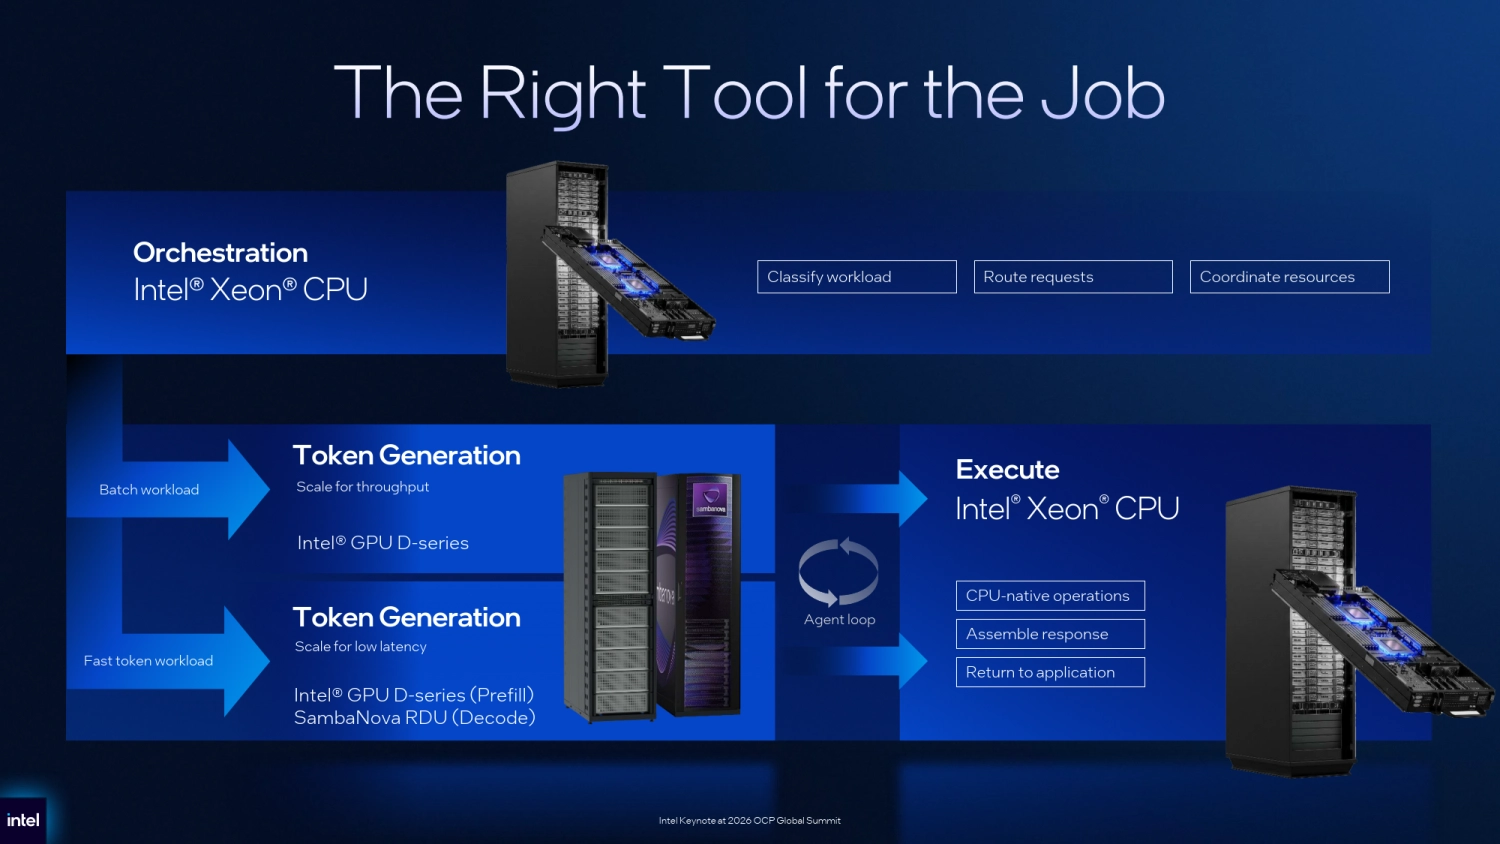
Intel 進一步示範這種異質運算分工:Batch Token Generation 交由 GPU D-series 處理;Fast-token Workload 則以 GPU D-series 負責 Prefill、SambaNova RDU 負責 Decode,而 Xeon 則位於 Agent Loop 的前後端,負責 Workload Classification、Request Routing、Resource Coordination、CPU-native Operations 與 Response Assembly。
這也說明 Intel 所強調的 Heterogeneous AI,並不是建立一套只容納自家加速器的封閉架構,而是讓不同類型的運算單元各自處理最擅長的工作。從這個角度來看,Xeon 更像是整個異質 AI 系統中的協調與控制層,負責把 GPU、RDU 與其他 Accelerator 串接成完整的 Agentic AI 工作流程。
總結
這次 Intel 公開的新一代處理器架構,真正值得看的其實不是單一規格,而是它開始更明確地回答一個問題:進入 Agentic AI 時代後,CPU、GPU 與 NPU 到底應該各自負責什麼?
Wildcat Lake 的答案,選擇不再把高階 SoC 所有功能原封不動塞進主流 PC,而是保留真正會影響日常體驗的 CPU、AI、記憶體與連線能力,並把用不到的 GPU 規模、Camera PHY、PCIe 與媒體功能精簡掉。Crescent Island 則反過來把資源集中在 AI 推論真正可能遇到的瓶頸,包括更大的模型、更多 KV Cache、更長 Context 與更多並行 Session。到了 Diamond Rapids,Intel 更進一步把 Xeon 的角色從單純提供 CPU 算力,轉向整個 AI 系統的 Orchestration、Memory Fabric、I/O 與資料流中樞。
其中對一般 PC 市場影響最大的,反而很可能是 Wildcat Lake。因為它代表 Intel 不再認為「主流處理器」就只能使用前幾代架構,而是嘗試把 Cougar Cove、Darkmont、Xe3、NPU 5、Intel 18A 與新世代連線技術,引進更低的價位帶,再透過 Right-sized Compute、Organic MCP、UCIe 與平台精簡,把成本重新壓回主流市場能接受的位置。
如果這套策略最終能讓 OEM 做出價格合理、續航出色,又不會在日常效能上明顯妥協的產品,那麼它對中階與入門 Windows PC 的影響,可能會比單純再增加幾顆核心更實際。真正需要觀察的,是 Intel 宣稱的 BOM 成本節省,究竟有多少會反映在零售售價上,以及 18A、UCIe 與全新封裝設計在實機上的續航、噪音與效能,是否真的站得住腳。
至於資料中心端,Intel 現在更像是把戰略版圖先攤開來。D270 已開始進入客戶 Sampling,Diamond Rapids 的架構輪廓也已相當完整,但第三方推論效能、Token/s、Latency、Tokens/Watt、正式 SKU、價格與實際量產供貨,仍有大量空白需要補齊。因此,現階段還不能單憑架構規格,就判定 Intel 已經在 Agentic AI 市場取得優勢。
但至少有一件事已經相當清楚:Intel 不再想用一種處理器解決所有 AI 工作負載,而是希望把 PC、GPU 與 Xeon 重新放回最適合的位置。Wildcat Lake 負責端點,Crescent Island 負責大規模推論,Diamond Rapids 則負責協調整個系統。
Intel 接下來真正要證明的,不是這三塊拼圖畫得漂不漂亮,而是當它們真正被放進 PC、伺服器與資料中心之後,能不能做到那句最核心的策略 —— 把每一個 Prompt,送到最適合的運算資源上。
延伸閱讀