
俄羅斯網友在 Avito 以 35 美元談下礦機,9 張 P106 合計 54GB VRAM,礦機跑 LLM 實測 30+ tok/s,但 PCIe x1 頻寬與 Pascal 老架構仍是主要限制。
俄羅斯網友 35 美元談下 9 卡礦機,54GB VRAM 一次到位
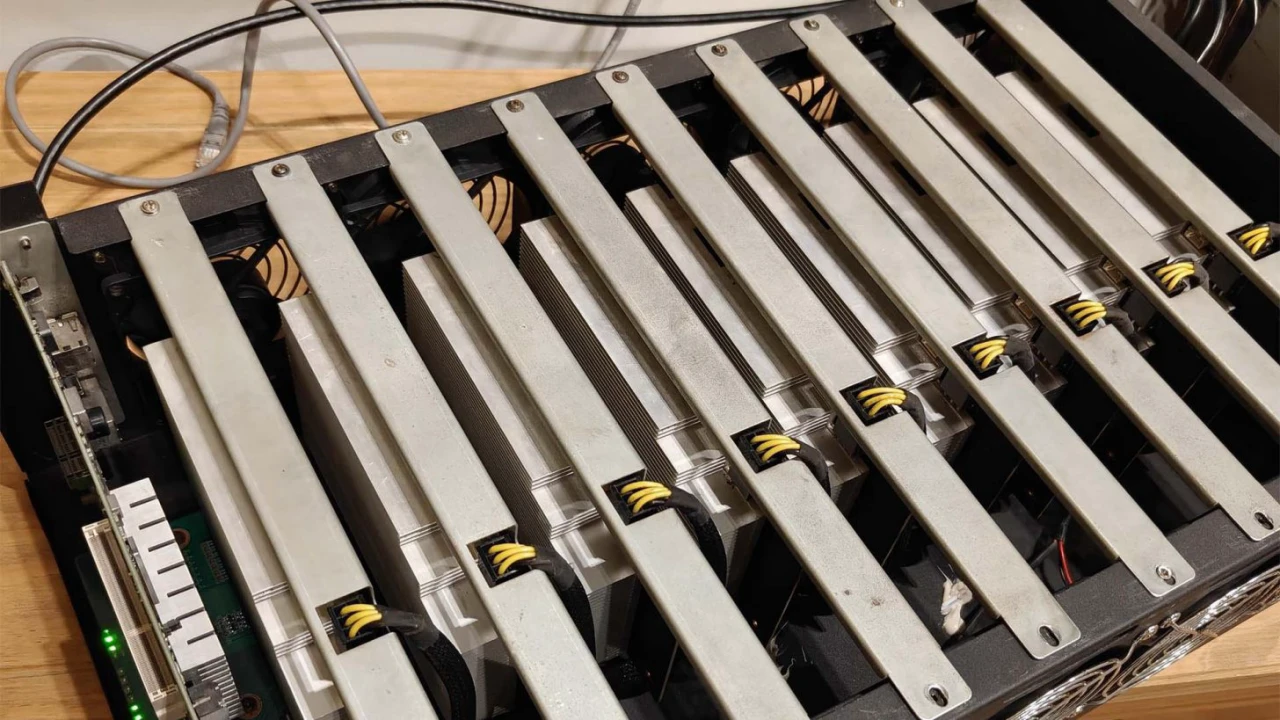
加密貨幣挖礦熱潮退去後,二手市場多了一堆被淘汰的礦機,沒想到反而成了本地 AI 玩家的撿便宜天堂。根據 Reddit 上就有網友分享,他在俄羅斯的分類廣告平台 Avito (可以想成俄羅斯版的 eBay 或 Facebook 賣場) 上,看到一台塞滿 9 張 GPU 的礦機。賣家開價 5,000 盧布,約 NT$ 1,800,他一路殺價到 3,000 盧布成交,折合約 NT$ 1,100。
這 9 張卡全是 NVIDIA 的 P106,每張配備 6GB VRAM,加總起來就是 54GB,P106 是專為挖礦推出的版本,說穿了就是 GTX 1060 的礦卡版。這類礦卡多半沒有影像輸出,只賣給企業客戶,保固期也比一般 GeForce 顯卡短。換句話說,這批卡本來就不是設計給一般消費者長期使用的,買二手時要有心理準備。
AI 方面,本地端跑大型語言模型,最吃的就是顯示記憶體容量。模型必須完整放進 VRAM,只要有一小部分溢出到系統記憶體,生成速度就會掉到原本的十分之一左右,因為 PCI Express 匯流排比 GPU 自己的記憶體慢上幾十倍。至於容量需求,以 Q4_K_M 量化來說,70B 模型大約需要 40GB 的 VRAM。這麼一算,54GB 不但裝得下 70B 等級的 4-bit 模型,還留有放 KV Cache 的空間。原文也提到,這台機器可以用 8-bit 量化跑 27B 等級的 Qwen,並支援 4-bit 或 5-bit 量化的 70B 模型。
礦機的多卡架構也剛好對得上推論的需求。早在 2024 年,就有網友分享過自己的多卡配置,並指出推論工作負載其實很像比特幣挖礦,只需要在各張卡之間傳遞小量、頻寬需求不高的資料。這也解釋了為什麼一堆「老骨頭」湊在一起,還真的能派上用場。
這位網友也實際跑了 AI 工作負載。他表示,在 Ollama 上執行 Qwen3.6 35B-A3B,可以拿到 30 tokens/s 以上的速度,而且他有免費電力可用,不用煩惱電費。由於這台礦機本來就沒有 SSD,他乾脆用一支 USB 隨身碟開機,並認為再做些最佳化,還能把速度往上拉。從模型命名推測,A3B 應該是指每次只啟用約 30 億參數的 MoE (混合專家) 架構,這類模型對頻寬的壓力相對小,也是老卡能跑出這個數字的關鍵之一。
不過,把這台機器當成「千元工作站」可能想得太美,P106 屬於 2016 年推出的 Pascal 世代,規格為 192-bit 的 GDDR5,記憶體有效時脈 8,008MHz,單卡功耗約 120W。換算下來單卡頻寬約 192 GB/s,對照RTX 3090 的 936 GB/s,只有大約五分之一。推論屬於記憶體頻寬導向的工作,兩張卡跑同一個模型時,頻寬高的那張幾乎都會贏。
一般礦機普遍採用 PCIe x1 介面,卡與卡之間搬資料的速度會形成明顯瓶頸,這次 30+ tok/s 的成績來自 MoE 模型,如果換成每個 token 都要動用全部參數的 70B 稠密模型,速度會保守許多。另一個現實問題是電費,若以單卡約 120W 粗估,9 張卡滿載時理論上會逼近 1,000W 以上,這位網友電力免費,一般人可就得精算了。
整體來看,這個案例證明了「VRAM 容量」在本地 LLM 的重要性,只要模型塞得進去,就算是老卡也能動起來。對於想體驗更大模型、又不想花大錢買新卡的愛好者,二手礦機確實是一條值得研究的路線。當然,也有人走不同的路:AMD Instinct MI50 32GB 只要約 200 多歐元,就能提供 1,024GB/s 的頻寬,只是得面對 ROCm 而非 CUDA 的軟體生態。不管選哪一種,買二手礦卡前都要把保固、功耗與介面限制納入考量,畢竟 NT$ 1,000 左右只是入場費,不是全部成本。
延伸閱讀