
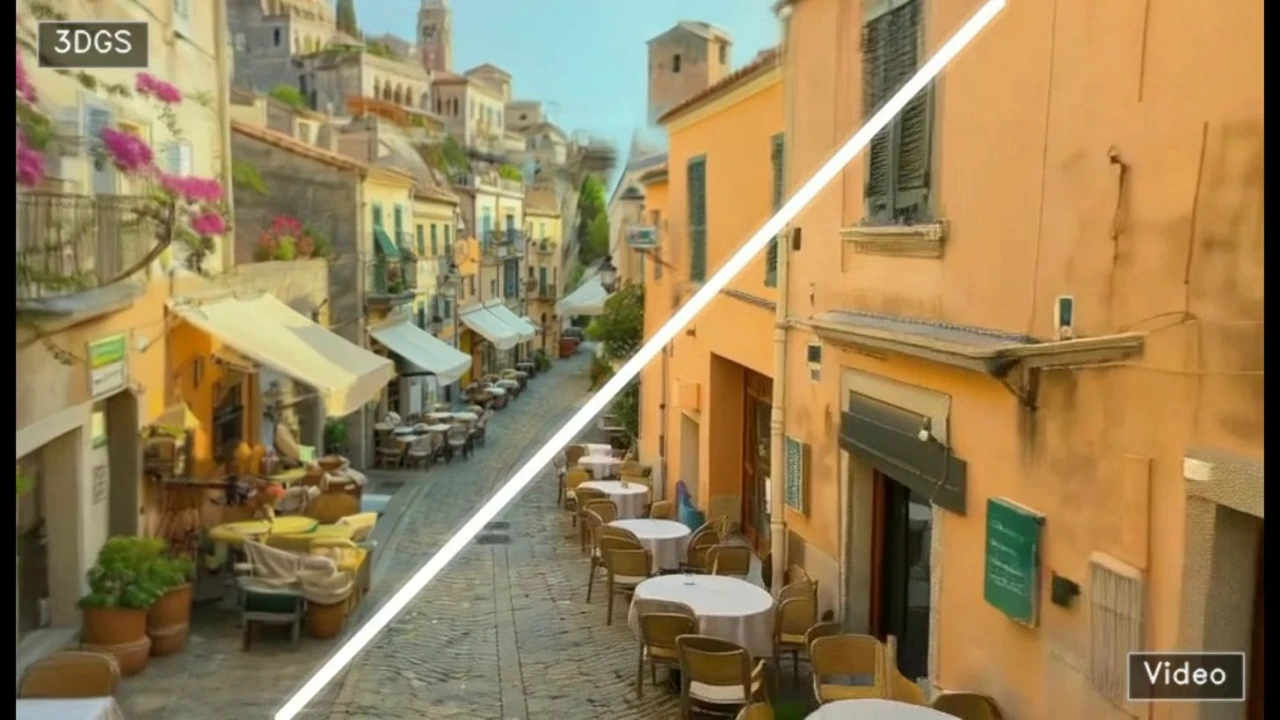
NVIDIA Lyra 2.0 只要一張照片就能生成可走動的 3D 場景,靠空間記憶解決回頭場景變樣的問題,去噪步驟從 35 步縮到 4 步,生成速度快約 13 倍,目前僅支援靜態場景。
Lyra 2.0 以幾何空間記憶加上模型自我糾錯
NVIDIA 旗下 Spatial Intelligence Lab (SIL) 開發的 Lyra 2.0,只需要一張普通照片,就能生成一個可以自由走動、轉身回望的 3D 環境。這項研究其實早在 2026 年 4 月就已經發表論文,這次 NVIDIA 趁著 SIGGRAPH Asia 2026 即將登場之前再次公開展示,讓它重新成為遊戲開發、VR 與機器人模擬圈的討論焦點。
要理解 Lyra 2.0 的價值得先從現有技術的老毛病說起,目前多數 AI 影片生成模型在處理長距離的鏡頭移動時,常出現兩種問題。第一種是「空間遺忘」:畫面一旦離開某個區域,模型就不記得那裡原本長什麼樣子,等鏡頭轉回來,往往把同一個地方重新「發明」一遍,建築結構與擺設全都對不上。第二種是「時間漂移」:影片是一段接著一段逐步生成的,每一步的小誤差會不斷累積,走得越遠,顏色與幾何形狀就扭曲得越嚴重。
這也是一般「圖片轉影片」工具只能產出固定片段、難以讓人真正「走進去」的原因。Lyra 2.0 的特色在於使用者可以自行控制鏡頭軌跡,隨著移動逐步生成新的視角,而不是被動觀看一段預先決定好的影片。
針對空間遺忘,NVIDIA 研究團隊設計了一套以 3D 幾何資訊為基礎的空間記憶系統,系統會替每一個生成的畫面保存對應的 3D 幾何資料,當鏡頭回到先前去過的區域,就能把相關的歷史畫面調出來當參考。不過,實際生成畫面的工作仍由影片模型負責,所以儲存的幾何資料就算有些誤差,也不會直接汙染新畫面。
針對時間漂移,研究團隊則在訓練階段刻意讓模型接觸自己產出的、帶有瑕疵的結果,讓它學會辨識畫質退化並加以修正,而不是把錯誤一路傳下去,「讓模型從自己的失誤中學習」的做法,是 Lyra 2.0 能撐起更長鏡頭路徑的關鍵。
整條流程可以這樣理解:使用者提供一張圖片與一條鏡頭軌跡,系統先生成一段模擬在場景中漫步的影片,再透過前饋式 (feed-forward) 3D 重建技術,把影片轉換成 3D 高斯潑濺 (3D Gaussian Splatting) 與多邊形網格。依照第三方技術媒體的整理,影片生成底層採用 140 億參數的 Wan 2.1-14B 擴散 Transformer,輸出解析度為 832 × 480,不過這部分細節以 NVIDIA 官方論文為準。
轉換完成的 3D 場景可以即時渲染,也可以匯出到 NVIDIA Isaac Sim 這類物理模擬環境。官方還提供互動式介面,讓使用者在累積的點雲中規劃鏡頭路徑,既能重訪已探索的區域,也能走向尚未生成的空間。根據論文,單一場景的範圍可延伸約 90 公尺,與 Google 的 Genie 3、Project Genie 這類同樣能生成可探索世界的系統相比,Lyra 2.0 的差異在於把生成內容重建成明確的 3D 幾何,後續能直接用在渲染與模擬上。
效能方面,NVIDIA 另外開發了一個蒸餾 (distilled) 版本,把影片生成所需的去噪步驟由 35 步壓縮到 4 步,生成時間約縮短 13 倍。依論文數據,在單張 NVIDIA GB200 GPU 上生成一段 80 幀的影片,完整模型需要約 194 秒,蒸餾版本只要約 15 秒。要注意的是,這不等於「即時生成世界」,後者的運算負擔依然很高。
在品質評比上,NVIDIA 表示 Lyra 2.0 在兩組資料集的測試中,於影像品質、風格一致性與鏡頭控制等多數指標上,勝過 GEN3C、Yume-1.5、CaM 等六種對照方法。不過以上結果出自 NVIDIA 自家論文,尚待外部團隊獨立驗證。
另一方面,在實際應用上最直接的是機器人訓練,研究團隊指出,機器人有機會在完全由 AI 生成的環境中學習導航,不必事先實地掃描真實世界的 3D 資料。遊戲與 VR 開發也是潛在受益者,AI 輔助的場景生成未來可能成為美術與關卡設計的輔助工具,不過距離「用一張圖直接生出完整可玩的遊戲」仍有一大段距離。然而限制同樣明確,Lyra 2.0 目前主要支援靜態場景,動態場景的生成仍是挑戰,偶爾也會出現畫面不一致的情形。
Lyra 2.0 的程式碼已公開在 GitHub,模型權重則放在 Hugging Face。依 GitHub 專案頁面的紀錄,官方在 2026/7/20 又補上了 GUI 與訓練程式碼。
延伸閱讀